π0.7 推理流程:机器人运行时究竟发生了什么
π0.7 是 Physical Intelligence 于 2026 年发布的机器人控制模型,论文编号为 arXiv 2604.15483。该页面按照左侧推理时间线的顺序,逐步展示一个机器人如何运行。Training 页面则解释每个模块中的模型是如何构建和训练的。
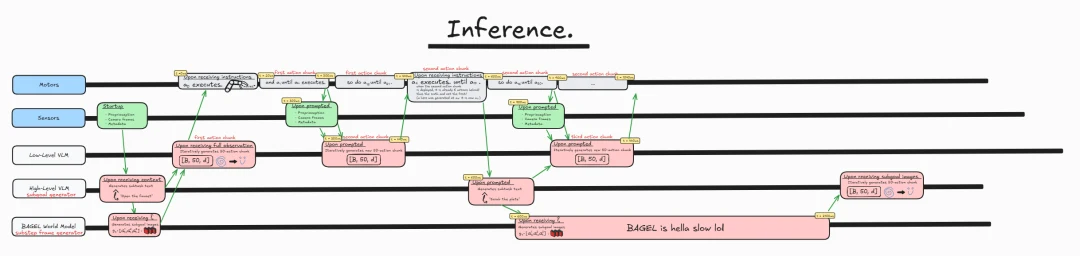
如何阅读这张推理图
可以把这张图理解为五个并行运行的时钟。两条蓝色通道代表硬件:
- Motors:执行动作;
- Sensors:读取相机和关节状态。
三条白色通道代表模型:
- low-level VLM:也就是 π0.7 本身,将观测转换为机器人动作;
- high-level VLM:以文本形式写出下一个子任务;
- BAGEL World Model:绘制完成该子任务后场景应该呈现的图像。
黄色标签表示时间。 ms 表示第一个动作开始执行的时刻。
绿色模块读取传感器,粉色模块运行模型,灰色模块执行动作。绿色箭头表示数据从一条通道传递到另一条通道。
启动之后,三个模型运行在相互独立的线程中,不会彼此等待。每个模型都会使用其他模型当前已经产生的最新输出。因此,速度较慢的 World Model BAGEL 不会阻塞机器人运行。
左侧的三维视图会在两台 SO-101 机械臂上重放每个时间块。系统配置包括一个顶部相机和两个腕部相机,这也是该项目所针对的硬件结构。真实推理只需要几毫秒,但三维视图会将过程放慢并夸大动作幅度,使每一步都更容易观察。页面中的动作是预先编写的,浏览器中不会实际运行模型。可以使用键盘上的 ← 和 →,或者页面上的按钮,在不同模块之间切换。若不进行操作,演示会自动播放并循环;每次循环都会让机器人继续执行后续两个子任务。
1. 启动:读取传感器
在机器人开始运动之前,系统首先收集初始观测。
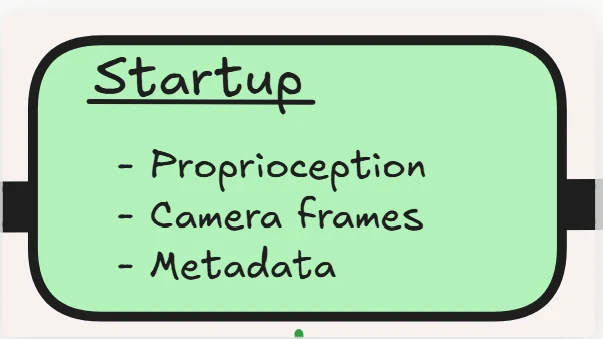
相机帧
每个相机提供一张图像,并被缩放为 像素。当前硬件配置包含三个相机:
- 安装在龙门架上的顶部相机,对应论文中的前置相机;
- 安装在左侧机械臂腕部的相机;
- 安装在右侧机械臂腕部的相机。
Proprioception
系统读取两台机械臂当前的关节位置。每台 SO-101 机械臂包含五个关节和一个夹爪。
metadata
metadata不是传感器直接测量得到的,而是由操作员设置。在运行时,论文始终要求模型采用训练数据中观察到的最佳行为:
- 质量等级为 5;
- 没有发生错误;
- 速度设置为该任务所有 episode 时长的第 15 百分位。
控制模式也在这里设定,可以选择 joint control 或 end-effector control。
在正常运行过程中,π0.7 还会读取每个相机最多五张历史帧。历史帧之间间隔 1 秒,并且每张图像都对应相匹配的关节状态。启动阶段还没有历史信息,模型需要能够处理这种情况。训练时,30% 的样本会完整移除历史信息,以提高模型在缺少历史观测时的适应能力。
2. high-level policy 写出第一个子任务
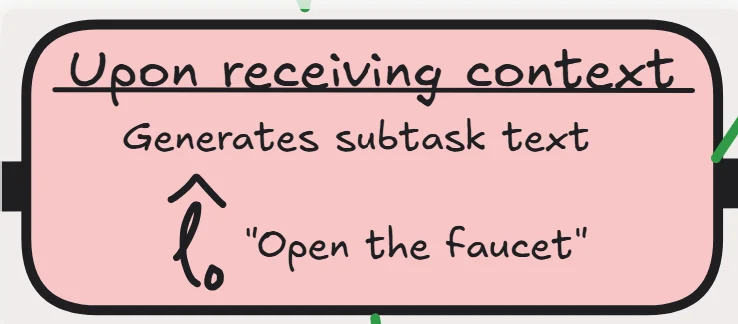
high-level policy 读取当前相机图像、总体任务,以及截至当前已经发布的子任务列表。启动时,子任务列表为空。
随后,它以逐个 token 生成的方式写出下一个子任务:
即“打开水龙头”。
该模型与 π0.7 使用相同的 Gemma-based 架构,但经过 coaching data 微调。在数据采集过程中,人类会逐步告诉机器人应该怎样执行任务,high-level policy 由此学习如何自主发布这些指令。
在时间线图中,这条通道标记为 subgoal generator。它生成的 subgoal 是文本形式的子任务指令,而 subgoal images 则由下方的 BAGEL 通道生成。
3. BAGEL World Model 绘制第一个子目标图像
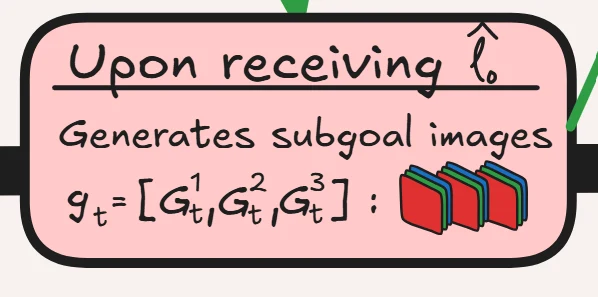
World Model 接收三个输入:
- 子任务 ;
- 当前相机图像;
- 元数据。
然后它生成:
其中,每个相机对应一张图像,描述当子任务完成后该相机应该看到的场景。
在当前示例中,生成的目标图像显示水龙头把手已经被抬起,并且水流已经打开。
BAGEL 是一个拥有 140 亿参数的模型,初始化自 ByteDance 的 BAGEL 开源图像生成与编辑模型。它从随机噪声开始,通过 25 个 denoising steps 生成一组目标图像。论文测得,在四张 H100 GPU 上生成一组图像平均需要 1.25 秒。
启动时,π0.7 会等待第一组目标图像生成完成。论文中的 Algorithm 1 会在生成第一个 action chunk 之前,先完成 subgoal image 的采样。
在此之后,只要子任务发生变化,或者距离上一次生成已经过去 4 秒,系统就会在后台生成新的目标图像。
4. π0.7 计算第一个 action chunk
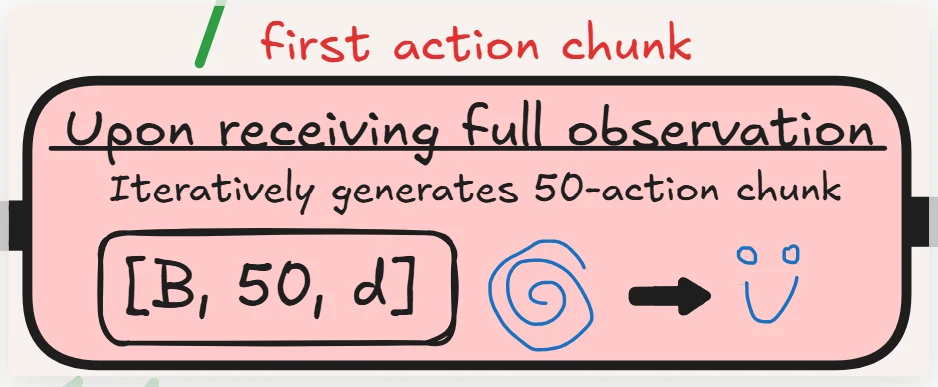
在获得完整观测和 prompt 后,π0.7 会计算一个 action chunk。prompt 包括:
- 总体任务;
- 当前子任务;
- subgoal images;
- 元数据;
- 控制模式。
模型输出接下来的 50 个动作:
其中运行时的 batch size 为 。机器人每秒执行 50 个动作,因此 50 个动作覆盖约 1 秒的运动。
Gemma backbone 首先读取一次完整上下文。随后,Action Expert 从随机噪声开始,也就是图中的螺旋状轨迹,通过 5 个 denoising steps 将其逐步转换为干净的 action chunk。
在三维视图中,每个点表示 50 个动作中的一个动作执行后夹爪的位置。最开始这些点分布在较大范围内,经过 5 次更新后逐渐收敛到一条稳定轨迹。
在一张 H100 GPU 上,最小配置下的推理时间为 38 ms。该配置使用三个相机,不包含历史帧和 subgoal images。启用历史信息和 subgoal images 后,推理时间最高可达到 127 ms。
π0.7 还可以选择在每个 denoising step 中运行两次推理:
- 一次包含元数据;
- 一次不包含元数据。
然后,模型将结果沿着元数据所指定的方向进一步推动。这种方法称为 classifier-free guidance。对于 dexterous manipulation 任务,论文使用的 guidance strength 为 1.3 到 2.2。
5. 第一个动作执行
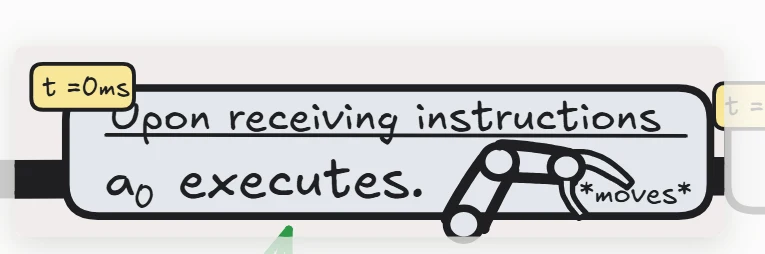
第一个动作 被发送给电机。
在 joint control 模式下,一个动作对应每个关节的目标位置。简单的 PD controller 会驱动每个关节逐渐接近目标位置。SO-101 使用的 STS3215 舵机在硬件内部运行这一位置控制环。
机器人以 50 Hz 的频率运行,因此每 20 ms 应用一个新动作。机械臂在这么短的时间内实际只移动几毫米,但三维视图会将这段位移放大。
6. 执行动作 a_1 到 a_14
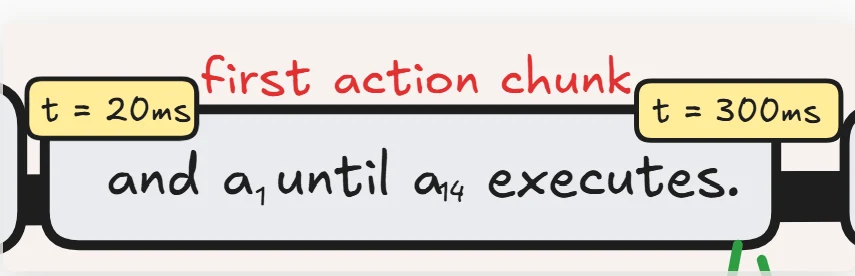
机器人每隔 20 ms 执行 action chunk 中的一个动作,而不会在每一步重新请求模型推理。
π0.7 实际只执行 50 个动作中的前 15 个或前 25 个动作。该演示采用 15 个动作,因此:
动作 到 总共执行 300 ms。
如果完整执行整个 action chunk,机器人实际上执行的将是一秒之前制定的计划。另一方面,如果每个动作都重新请求模型推理,也无法满足实时要求,因为一次推理耗时超过 20 ms。
因此,系统执行 15 个动作后重新规划。这种方式在动作连续性和实时响应之间取得平衡。
7. 获取新的观测
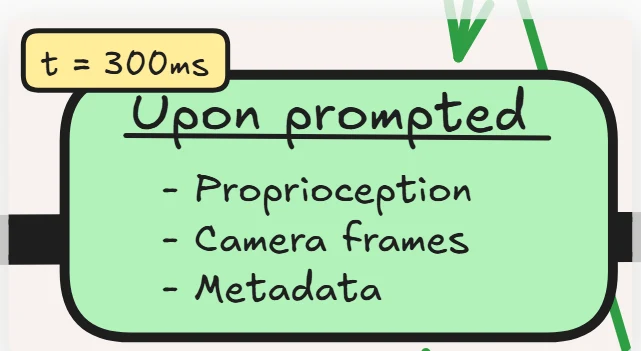
执行 15 个动作后,传感器再次读取新的观测:
- 新的相机帧;
- 新的关节位置。
元数据保持不变。
这次观测会启动下一轮推理。
8. 机械臂运动过程中计算第二个 action chunk
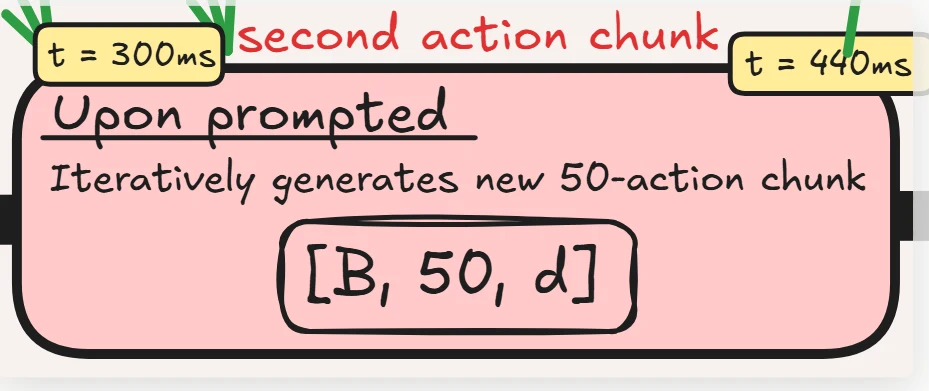
π0.7 根据新的观测计算一个新的 50 步 action chunk。当前子任务和 subgoal images 保持不变。
时间线图为该计算分配了 140 ms。论文测得,π0.7 的实际推理时间根据配置不同,在 38 ms 到 127 ms 之间变化。
机器人不会停下来等待模型完成推理。在这 140 ms 内将要执行的动作已经确定,它们来自第一个 action chunk 的剩余部分。π0.7 会被告知这些动作是什么,并生成一个以这些动作作为开头的新 action chunk。
这就是 real-time chunking。
训练阶段,π0.7 已经学习过这种情况:模型会接收一个 action chunk 开头的 0 到 12 个无噪声动作,然后学习如何在此基础上继续生成后续动作。
9. 同时执行动作 a_15 到 a_21
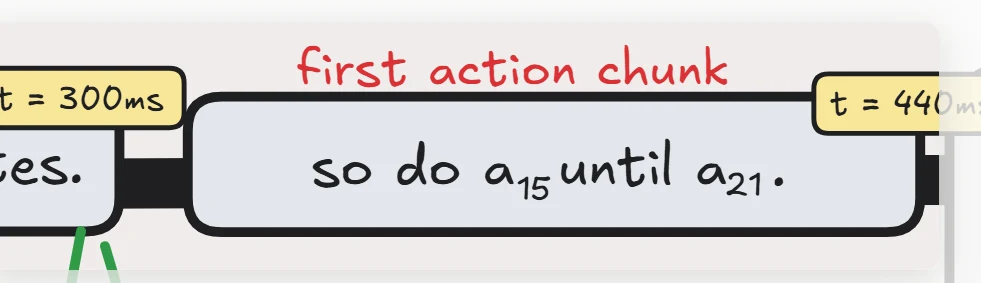
在 GPU 计算新 action chunk 的同时,电机继续执行第一个 chunk 中的动作:
这 7 个动作在 140 ms 内完成。
机器人不会因为模型正在计算而等待。
10. 切换到第二个 action chunk
第二个 action chunk 到达时,它是根据 300 ms 时刻获取的观测规划出来的。因此,它的前几个动作描述的是已经发生的时间点。
在第二个 chunk 计算期间,机器人已经按照第一个 chunk 执行了这些动作。因此,执行过程不会从第二个 chunk 的第一个动作重新开始,而是直接跳转到与当前时间相匹配的位置。
在图中,这一位置被标记为第二个 chunk 的第 6 个动作 :
“它已经落后了 6 个动作,因此执行第 6 个动作,而不是第 1 个动作。”
由于 real-time chunking 要求新 chunk 从机器人实际已经执行的动作开始,因此两个 chunk 之间可以平滑衔接。
从此以后,系统不断重复以下循环:
执行动作 → 获取观测 → 在后台计算下一个 chunk → 切换到新 chunk。
11. 子任务发生变化
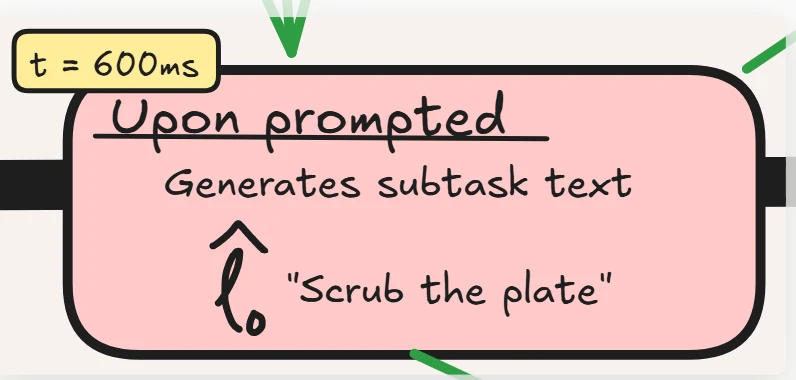
high-level policy 再次读取最新观测。
由于“打开水龙头”已经出现在已完成子任务列表中,模型生成下一个子任务:
即“擦洗盘子”。
论文说明,子任务生成运行在独立线程中,但没有明确给出它的运行频率。该演示将这一事件安排在 600 ms 时刻。
12. BAGEL 重新绘制子目标图像
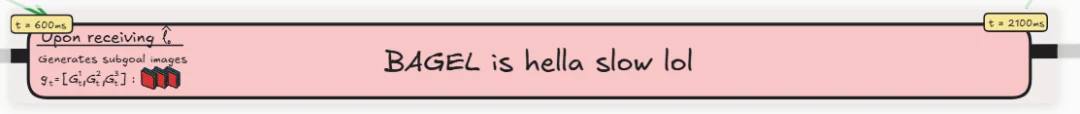
新的子任务意味着旧的 subgoal images 已经失效。因此,World Model 根据当前图像和新子任务“擦洗盘子”,开始生成新的一组目标图像。
时间线图用 1.5 秒表示这一过程,对应 75 个机器人动作。论文测得,即使使用四张 H100 GPU、8-bit 矩阵乘法,以及接近 10,000 个 token 的序列,并且在每个 denoising step 中同时对文本和图像执行 guidance,BAGEL 仍然需要约 1.25 秒。
图中写着:
“BAGEL 非常慢。”
但图像生成不会阻塞其他模块。BAGEL 工作期间,π0.7 仍然继续控制机器人执行动作。
13. 机械臂完成旧 action chunk
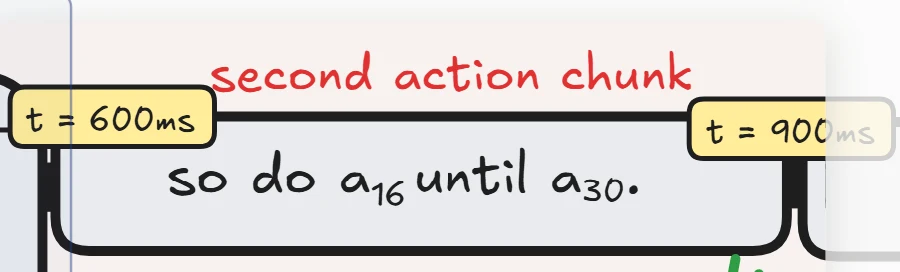
电机继续执行第二个 action chunk 中剩余的动作。在图中,这些动作是:
该 chunk 是在“打开水龙头”这一子任务下生成的。新的“擦洗盘子”子任务会在下一次低层推理时生效。
14. 再次获取观测
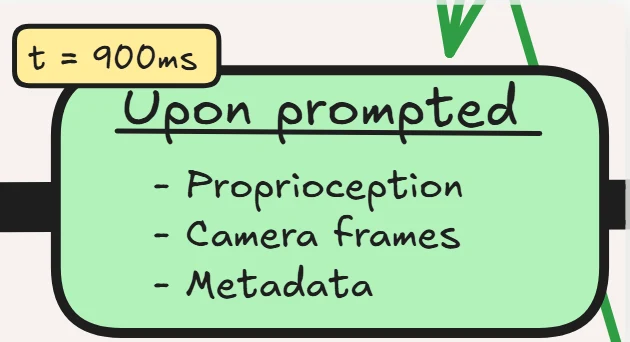
系统再次读取新的相机帧和关节位置。
这次读取过程与 300 ms 时刻的读取过程相同,只是机器人又执行了 15 个动作。
15. 在新子任务下生成第三个 action chunk
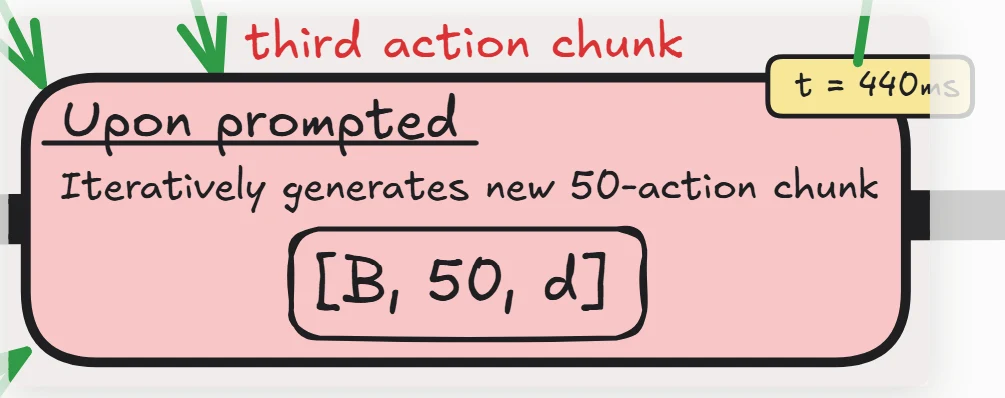
这是第一个根据“擦洗盘子”这一新子任务规划的 action chunk。
但是,此时新的 subgoal images 还没有生成完成,BAGEL 仍在工作。
论文指出,π0.7 始终使用当前可获得的最新 subgoal images,但没有说明在这一间隔期间,模型究竟会:
- 继续使用旧子任务对应的图像;
- 还是在新图像生成完成之前暂时移除图像。
无论采用哪种方式,模型都已经为这种情况做好准备。训练过程中,75% 的样本不包含 subgoal images,因此 π0.7 能够仅依靠子任务文本执行动作。
时间线图中这一模块的结束时间标注为 ms,但根据上下文,它应当是 ms。
16. 执行、观测、计算并切换
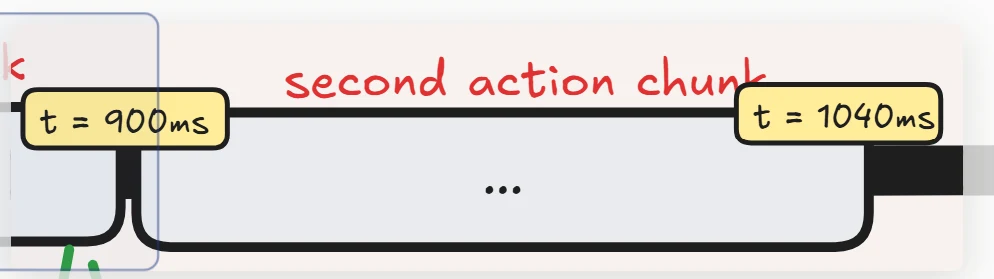
在第三个 action chunk 准备完成之前,电机继续执行已有动作。
当第三个 chunk 在 1040 ms 时刻准备好之后,系统按照之前相同的方式切换到新的 chunk。
此后,时间线图省略了重复过程,用省略号表示持续循环:
- 每隔 300 ms 获取一次新观测;
- 进行约 140 ms 的推理;
- 切换到新的 action chunk。
17. 新的 subgoal images 到达
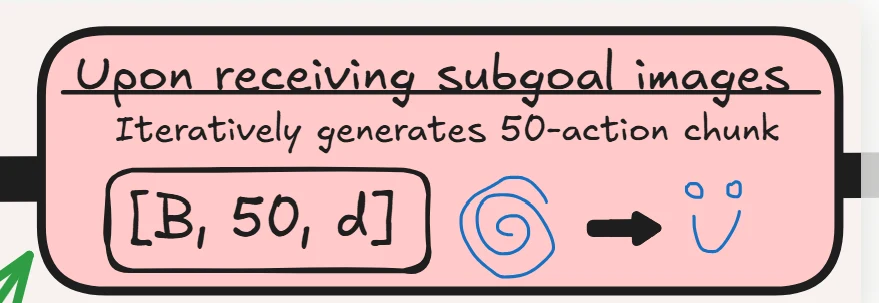
BAGEL 完成了新目标图像的生成。
从下一次推理开始,每个 action chunk 都会使用“盘子已经擦洗干净”对应的目标图像。除非子任务发生变化,或者距离上一次生成已经过去 4 秒,否则这些图像会继续使用。
机器人会一直采用这种方式运行,直到任务完成:
- high-level policy 更换子任务;
- BAGEL 重新绘制目标图像;
- π0.7 在每隔几百毫秒的时间尺度上,将子任务和目标图像转换为新的 50 步 action chunk。
整个演示随后进入循环。每次循环都会让机器人继续执行后续两个子任务:
- 将海绵放回原处;
- 关闭水龙头;
- 然后再次打开水龙头。
需要注意的是,图中的这一模块被画在 high-level 通道上,但实际负责规划 action chunk 的仍然是 low-level policy,也就是 π0.7。
Training:π0.7 如何被训练出来
前言
论文经常会把并不复杂的问题写得过于复杂。这份解读面向以下读者:已经对机器学习模型如何学习有基本直觉的人;喜欢数学的人;刚开始接触机器人领域的人;不想完整阅读 π0.7 原论文的人;以及其他任何想了解 π0.7 的读者。
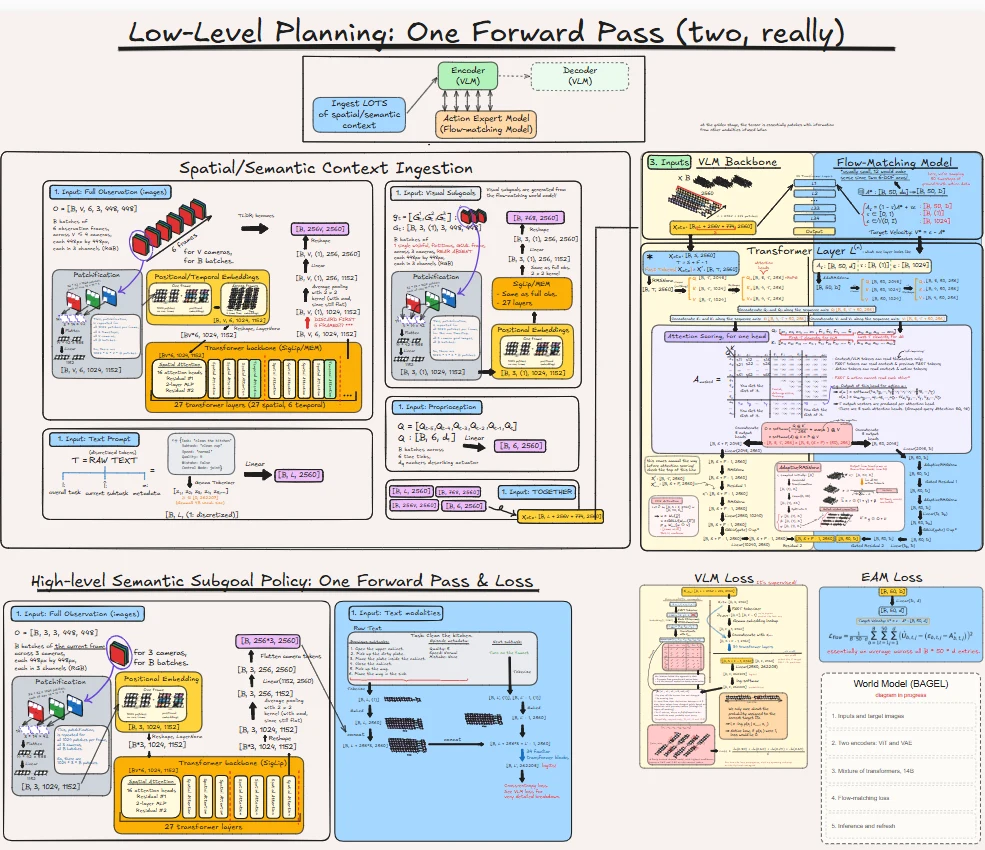
π0.7 的整体结构
π0.7 是 Physical Intelligence 于 2026 年发布的机器人控制模型,拥有约 50 亿参数。它读取相机图像、机器人关节位置和文本 prompt,然后输出机器人接下来要执行的 50 个动作。这类模型被称为 VLA,即 Vision-Language-Action model。
这篇论文最重要的设计是 prompt。
π0、π0.5 和 π0.6 等早期模型通常只接收简短的任务描述。π0.7 除了任务描述之外,还使用当前子任务指令、episode metadata、控制模式,以及部分样本中“几秒之后场景应该呈现的图像”。
episode metadata 包括:
- 机器人执行任务的速度;
- 执行质量;
- 是否发生错误。
这些标签让同一个模型可以从不同质量的数据中学习,包括失败的 episode、自主 rollout 和人类视频,而不必把高质量行为和低质量行为简单平均。运行时,用户可以通过改变 prompt 中的内容来引导模型。
运行时有三个模型共同工作。
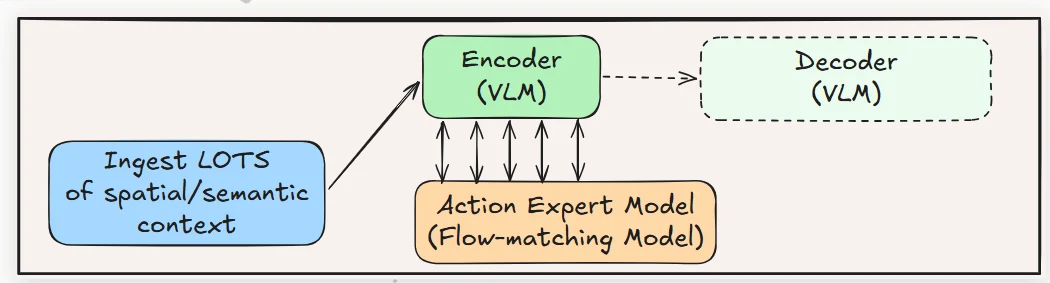
π0.7:low-level policy
输入图像、关节位置和 prompt,输出一个包含 50 个动作的 action chunk。
相关内容包括:
- context ingestion;
- decision model;
- training losses。
high-level policy
high-level policy 使用与 π0.7 相同的基础架构,但经过微调,可以以文本形式生成下一个子任务,例如:
“turn on the faucet”
即“打开水龙头”。
它帮助 low-level policy 始终围绕总体任务行动,而不会只关注当前局部动作。
World Model
World Model 是一个拥有 140 亿参数的图像生成模型,初始化自 ByteDance 的 BAGEL。它根据当前子任务生成目标图像,描述完成该子任务之后场景应该呈现的状态。
页面顶部的框图只展示 low-level policy:
- 接收多模态 context;
- 使用 Gemma 3 backbone 对 context 进行编码;
- 将编码结果传递给 Action Expert;
- 由 Action Expert 生成动作。
图中的 Encoder (VLM) 表示 Gemma 3 backbone。虚线框中的 Decoder (VLM) 表示 backbone 的文本输出。
π0.7 只在训练阶段使用这一文本输出,用于预测离散 action token。high-level policy 也使用同一个输出生成子任务。
你不必严格按照页面顺序阅读。每个主要章节都会先说明输入是什么、输出是什么,以及为什么需要这一模块。更底层的组件说明被折叠在各章节下方,点击架构图中的任意模块也会打开对应说明。
π0.7 论文并没有给出架构图中的每一个数字。部分层大小、patch 大小、memory encoder 的 attention schedule 和 action tokenizer 来自 π0.7 所依赖的其他工作,包括 Gemma 3、MEM、knowledge insulation、FAST 和 π0。页面会在相关位置说明哪些细节并未直接写在 π0.7 论文中。
图中符号说明
架构图中的 tensor shape 使用方括号表示,每个数字对应一个 axis。
例如:
表示共有 个训练样本,每个样本包含 个 token,每个 token 由 2560 个数字组成。
B
batch size,即同时处理的训练样本数量。
V
相机数量,最多为 4 个:
- front camera;
- left wrist camera;
- right wrist camera;
- 移动机器人上可选的 rear camera。
6
每个相机对应的帧数,包括当前帧和 5 张历史帧。历史帧之间间隔 1 秒。
448
图像缩放后的高度和宽度,单位为像素。
1024
每张图像经过切分后的 patch 数量。图像被划分为一个 的网格,每个 patch 的大小为 像素,因此总共有:
个 patch。
1152
SigLIP vision encoder 内部 token 的宽度。
2560
Gemma 3 backbone 内部 token 的宽度。所有输入在进入 backbone 之前,都必须被映射到这一宽度。
256
每张图像经过 pooling 后保留的 token 数量。
在 attention 内部,256 也表示一个 attention head 的宽度,但这两个 256 的含义彼此无关。
L
prompt 中的文本 token 数量。
S
完整 context 的长度:
其中:
768 是 subgoal image token 的数量,6 是 state token 的数量。
F
一个 action chunk 所包含的 FAST action token 数量。它会根据不同样本而变化。
T
训练过程中 backbone 内部的序列长度:
在 text prompt 模块中, 有时也表示原始文本。
50
每个 action chunk 中的动作数量。机器人每秒执行 50 个控制步骤,因此 50 个动作对应约 1 秒的运动。
d
单个动作中包含的数字数量,由机器人本体决定,通常包括关节目标位置和夹爪指令。
D 与 D_E
Action Expert 及其 feed-forward layer 的宽度。论文只给出了 Action Expert 的总参数量:8.6 亿。
262208
Gemma 3 的 vocabulary size,即词表中 token 的数量。
(1)
一个大小为 1 的 axis。它被保留在 tensor shape 中,用于表明某个 axis 已经被压缩为单个元素。例如,历史信息压缩后只保留一帧时,就会出现这一维。
A^* 、 ε 和 τ
分别表示:
- ground-truth action chunk;
- Gaussian noise;
- 介于 0 和 1 之间的 Flow Matching 时间变量。
Spatial & semantic context ingestion
这是整个输入处理引擎。
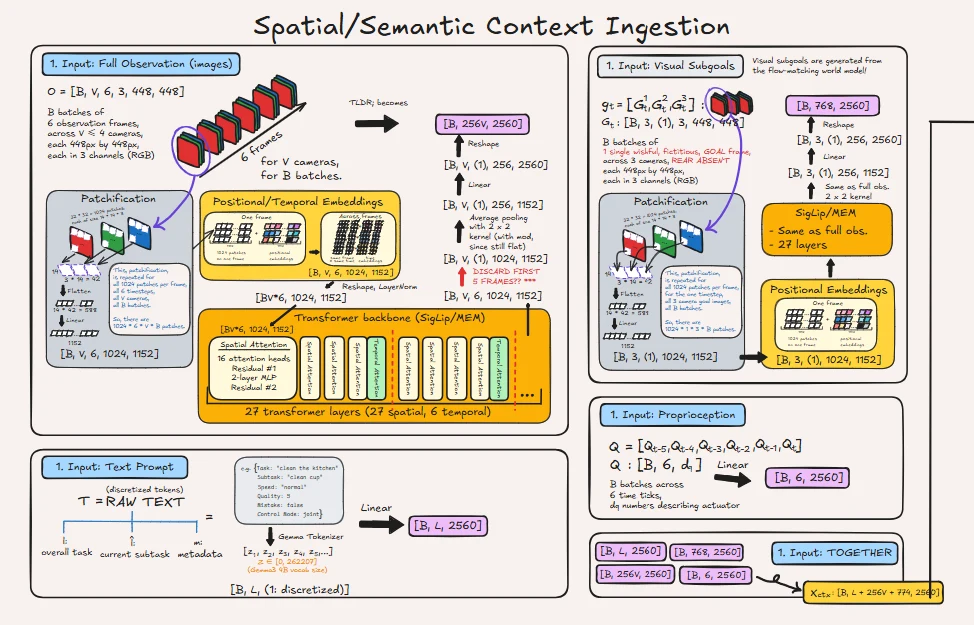
训练过程中,它为预测机器人接下来要执行的 50 个动作提供全部上下文,包括:
- 来自 3 个或 4 个相机的完整图像,每个相机包含 6 帧历史;
- 文本,包括总体任务、当前子任务、episode metadata 和控制模式;
- Proprioception,表示机器人自身所处的状态,即 6 个时间步上的关节位置;
- Visual subgoals,即几秒之后场景应该呈现的最多 3 张图像。
训练时,这些目标图像可能是真实的未来帧,也可能是 World Model 生成的图像。运行时,它们由 World Model 生成。
每一种输入的形式都不同:
- 图像是像素;
- 文本是词;
- Proprioception 是关节角度。
Ingestion 模块会将所有输入转换为一系列向量,每个向量的宽度都是 2560,与 Gemma 3 backbone 的 token 宽度一致。
这些向量连接起来后,形成一个统一的 tensor:
该 tensor 位于这一模块右下角,后续所有模块都只读取 。
训练过程中,prompt 的部分内容会被随机删除,但 control mode 始终保留。因此,模型在运行时也能够处理不同输入组合。
Subgoal images 只出现在 25% 的训练样本中。
Full observation
这一模块使用标准的 VLM image encoder,并将其扩展到视频输入。
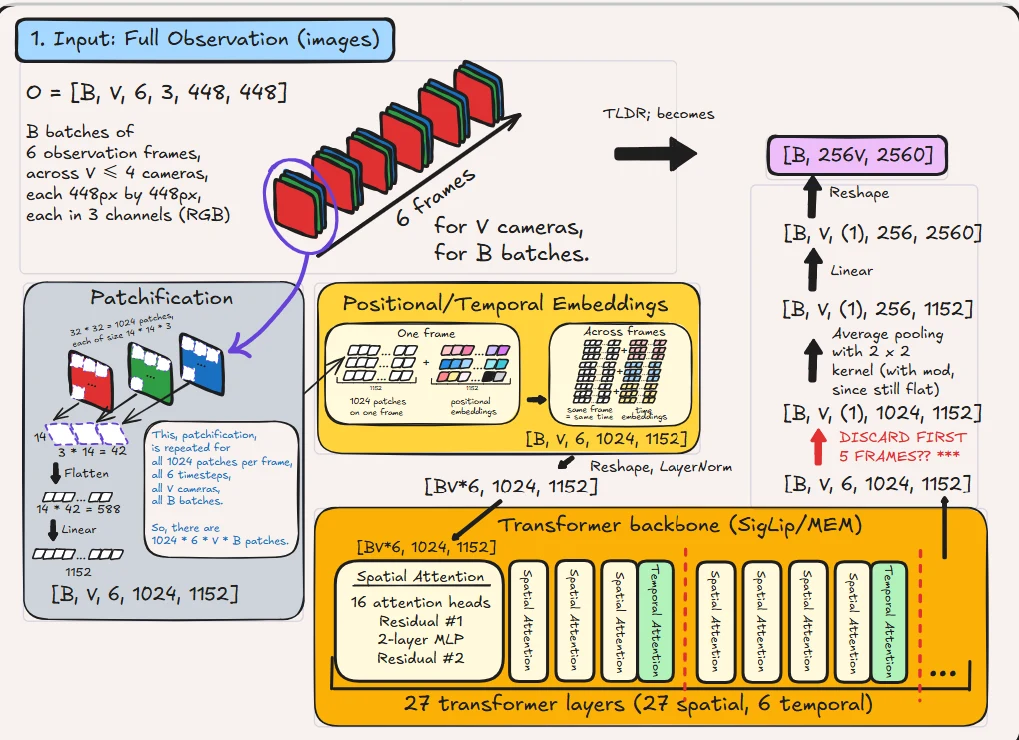
每个相机提供 6 帧:
- 当前帧;
- 5 张历史帧,每张间隔 1 秒。
每一帧都会被切分为 patch。每个 patch 都会获得一个 positional embedding,用于记录它在图像中的位置。
随后,这些 patch 经过 27 个 Transformer layer。
每一层都会执行 spatial attention。在 spatial attention 中,每个 patch 读取同一帧中的其他 patch。
每隔 4 层,还会执行 temporal attention。在 temporal attention 中,每个 patch 会读取更早帧中相同位置的 patch。
此时 tensor shape 仍然是:
但当前帧中的 patch 已经携带了历史帧的信息。相机之间在这一阶段不会交换信息,相机之间的信息交互会在之后的 Gemma backbone 内部完成。
经过最后一个 temporal layer 后,5 张历史帧已经完成了信息传递,不再需要继续保留,因此被删除:
随后,pooling 和 linear projection 将每个相机压缩为 256 个 token,每个 token 的宽度为 2560。
最终得到:
这一 history encoder 来自 MEM。
它不会向 image encoder 中添加新的 learned weights,因此可以直接使用 Gemma 3 附带的 pretrained encoder。
Full observation input
输入由多个相机以及每个相机对应的 6 帧图像组成:
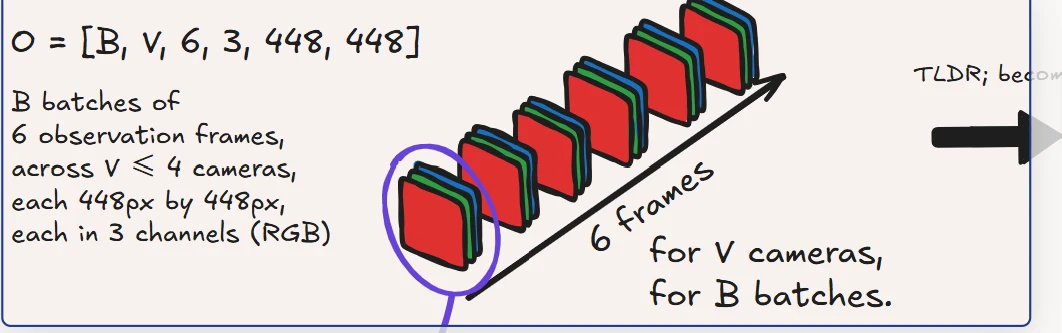
其中:
- 是 batch size;
- 是相机数量;
- 6 是每个相机的帧数;
- 是图像尺寸;
- 3 是 RGB 通道数。
Patchification
每张 的图像被划分为 个 patch,每个 patch 的大小为 像素。
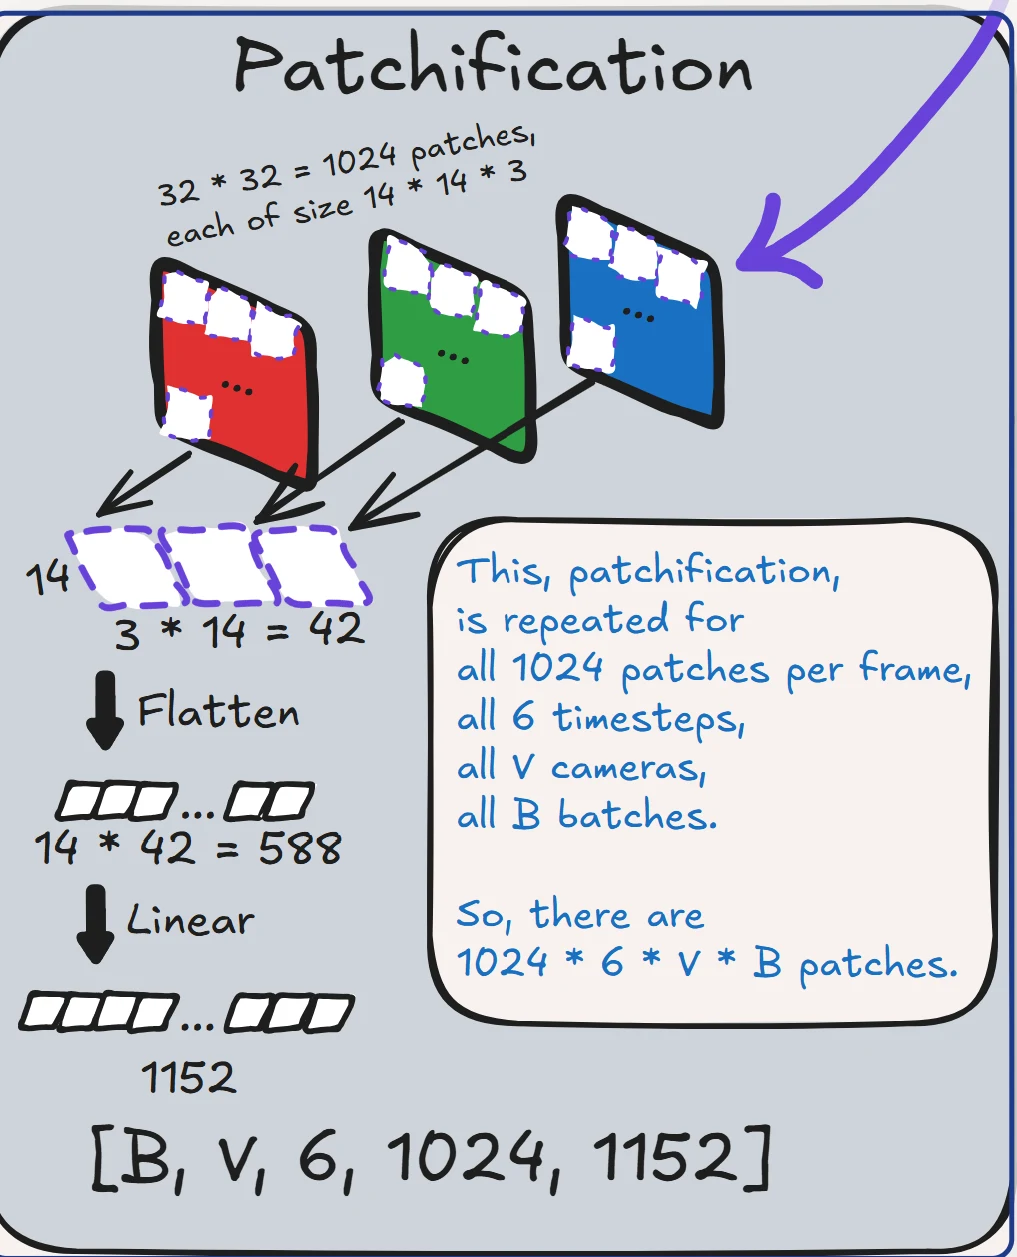
因此,每张图像包含:
个 patch。
经过 patchification 后,输入形状为:
每个 patch 会被展平,并映射为宽度为 1152 的视觉 token。
Positional / temporal embeddings
空间位置编码记录每个 patch 在当前图像中的位置。
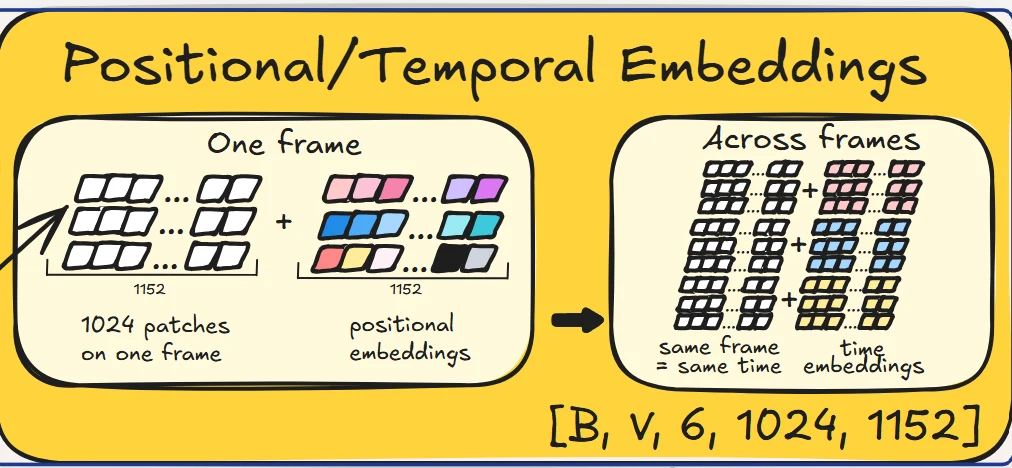
时间位置编码记录每个 patch 来自哪一个时间点。这样,模型可以区分:
- 当前帧中的某个 patch;
- 1 秒前相同位置的 patch;
- 更早历史帧中的相同位置 patch。
SigLIP / MEM backbone
视觉 token 经过 SigLIP 视觉编码器处理。
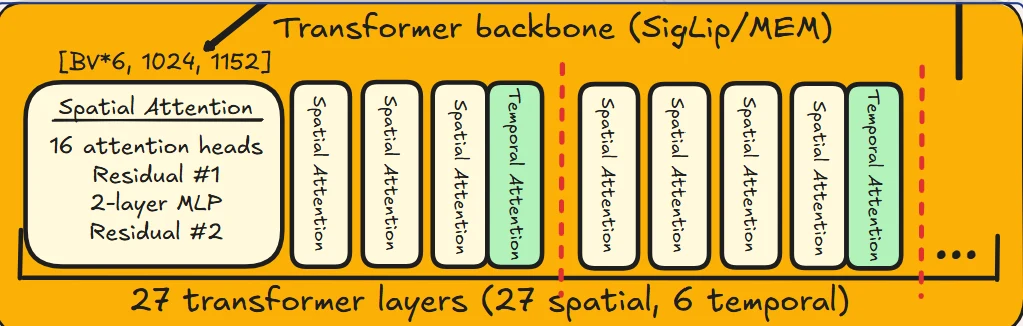
该编码器包含 27 个 Transformer layer:
- 每一层都执行 spatial attention;
- 每隔 4 层执行一次 temporal attention。
Spatial attention 只在同一帧内部进行。Temporal attention 则在不同时间的相同空间位置之间传递信息。
相机之间不会在这里直接交换信息。不同相机的内容会在之后的 Gemma backbone 中通过共享 attention 发生交互。
Frame selection、pooling 与 projection
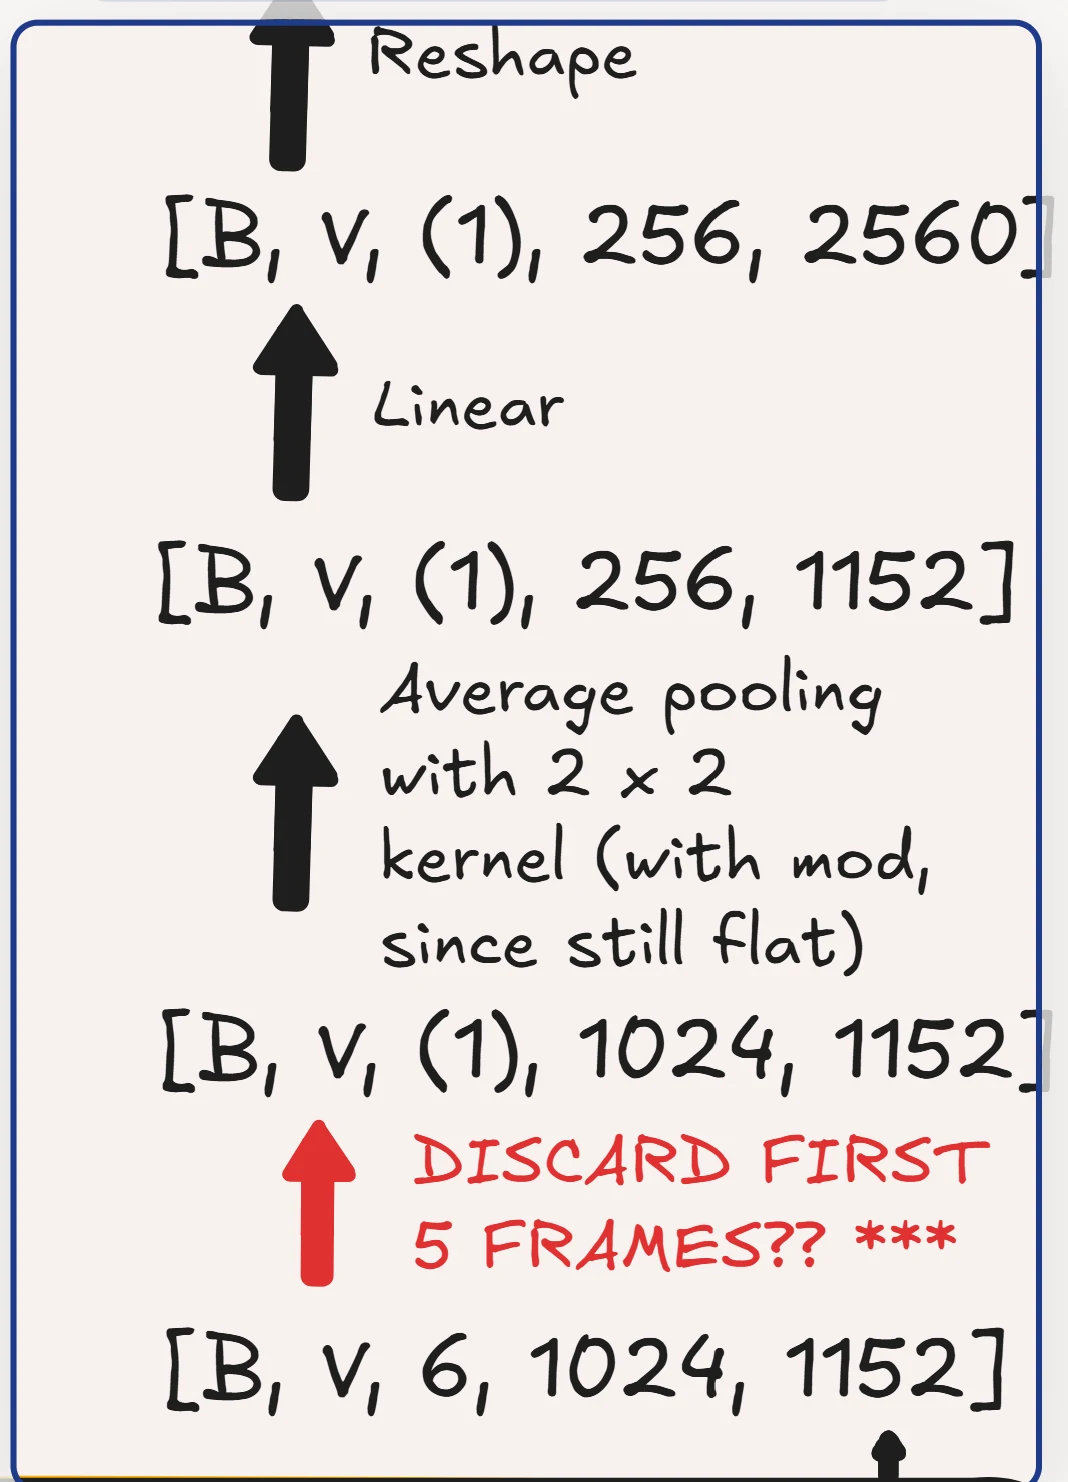
最后一个 temporal layer 之后,历史帧中的信息已经被写入当前帧,因此只保留当前帧:
随后,对视觉 token 进行 pooling,并通过 linear projection 将 token 宽度从 1152 映射到 2560。
每个相机最终得到 256 个 token:
展平相机维度后,得到:
Observation tensor
最终的 observation tensor 是:
其中每个相机贡献 256 个 token。
Visual subgoals
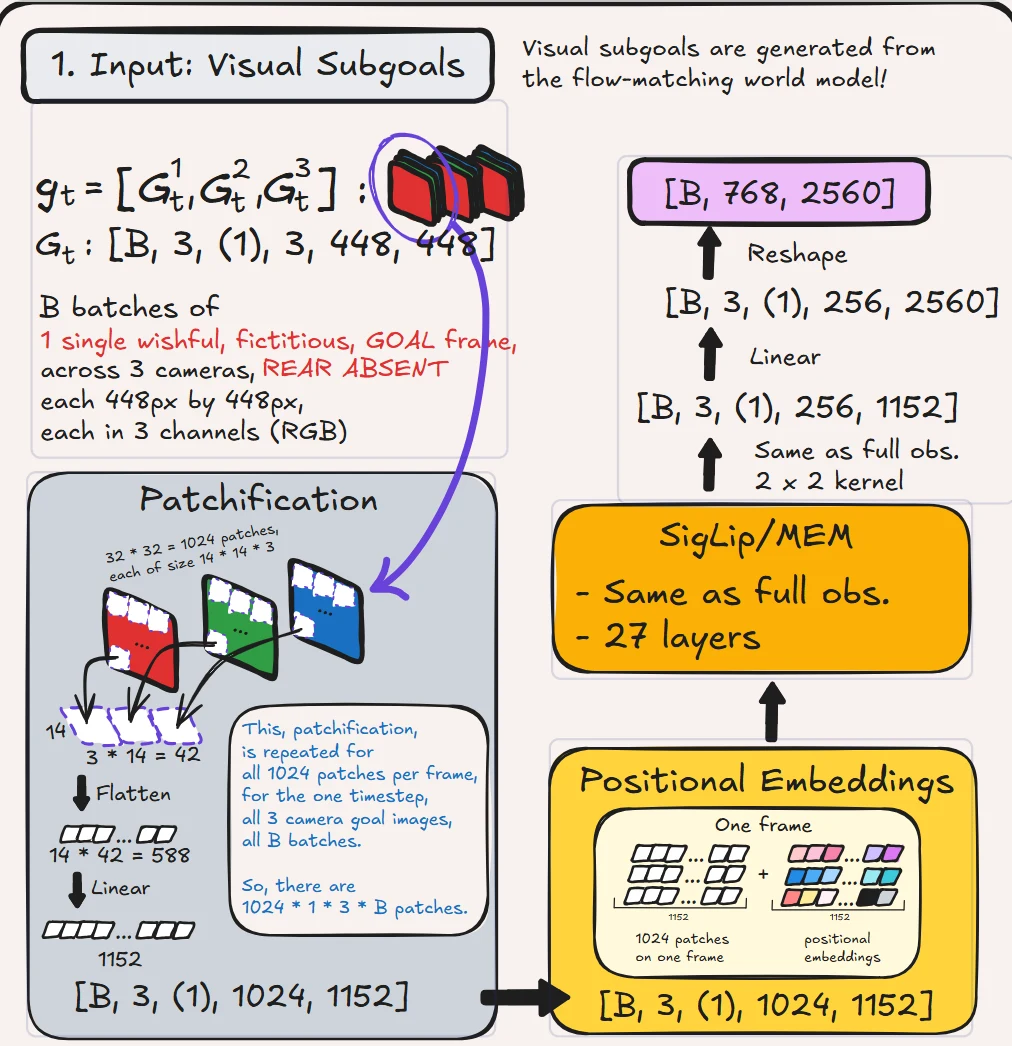
Visual subgoal 是一张描述几秒之后每个相机应该看到什么的图像。它表示机器人下一步应该产生的结果。
架构图将其称为:
“1 single wishful, fictitious, GOAL frame”
也就是“一张理想化、虚构的目标帧”。
例如,子任务“打开冰箱门”只说明机器人要做什么,而 subgoal image 还会进一步展示应该如何完成,例如夹爪应该位于门把手的什么位置。
最多可以生成 3 张 subgoal image:
- 一张对应 front camera;
- 一张对应 left wrist camera;
- 一张对应 right wrist camera。
rear camera 没有对应的 subgoal image。
这些图像使用与 observation frame 相同的 SigLIP encoder 和相同的 weights。每张 subgoal image 都只有单帧,因此 temporal layer 没有可供读取的历史信息。
最终输出为:
因为每张目标图像最终产生 256 个 token,3 张目标图像共得到:
个 token。
运行时,subgoal image 由 World Model 生成。World Model 初始化自 BAGEL,并使用 Flow Matching 训练。
World Model 的 Flow Matching 与 Action Expert 的 Flow Matching 是相互独立的:
- 一个用于生成图像;
- 一个用于生成动作。
训练过程中,π0.7 同时看到真实的未来帧和生成图像。
真实帧有两种来源:
- 以 0.25 的概率,取当前子任务片段结束时的帧;
- 否则,从未来 0 到 4 秒之间的随机时间点取帧。
Subgoal image 会显著降低训练难度,因为在当前图像和未来图像之间预测动作,本质上接近一个 inverse-dynamics 问题。
为了避免模型过度依赖 subgoal image,它们只出现在 25% 的训练样本中。在 subgoal images 存在时,子任务文本还会以 30% 的概率被删除。
Visual subgoal input
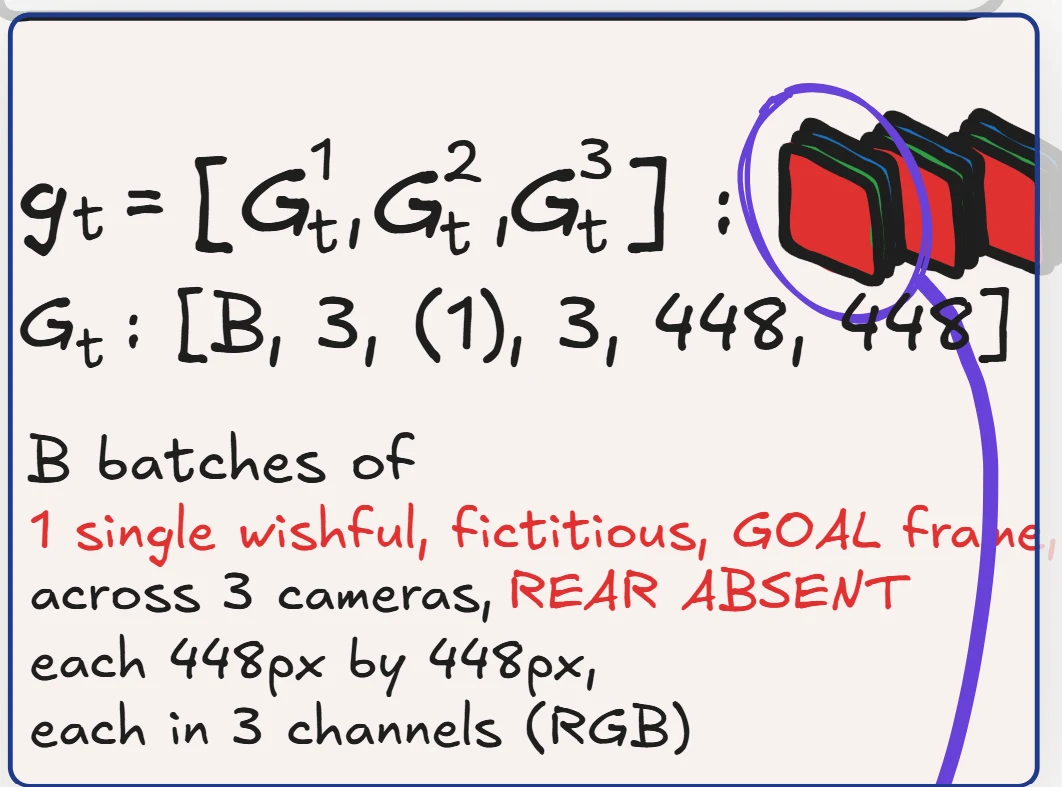
视觉目标图像的输入形状为:
其中 3 表示 front camera、left wrist camera 和 right wrist camera。
每一张目标图像都经过与当前观测相同的 SigLIP encoder,但只包含一帧,因此不使用 temporal attention。
Patchification
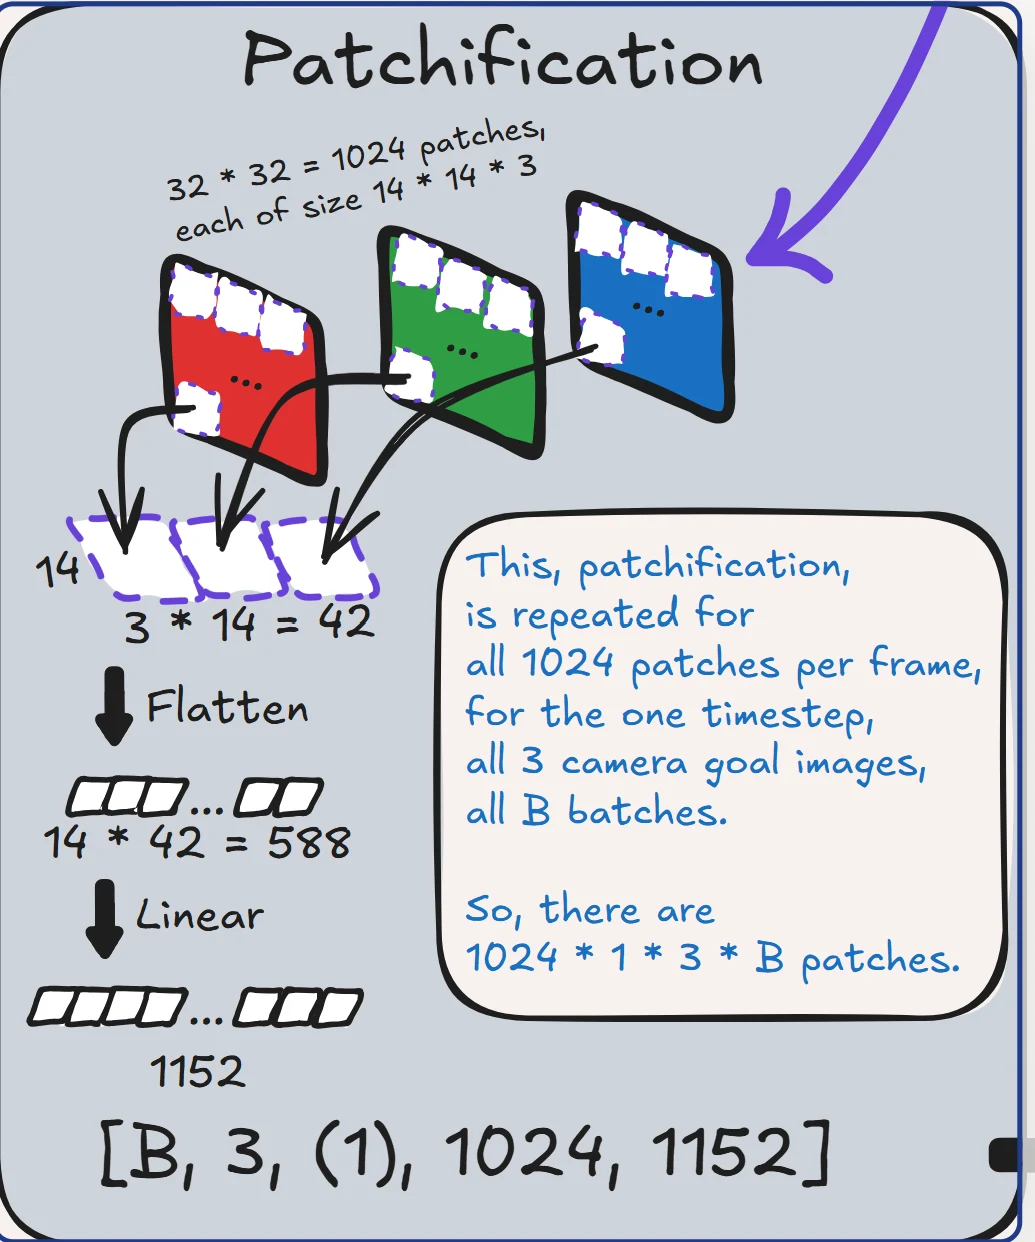
每张目标图像同样被划分为:
个 patch。
每个 patch 的大小为 像素。
SigLIP / MEM backbone
目标图像经过与观测图像相同的视觉编码器和相同的 weights。
由于目标图像只包含单帧,MEM 的时间建模部分没有历史帧可读取。
Positional embeddings
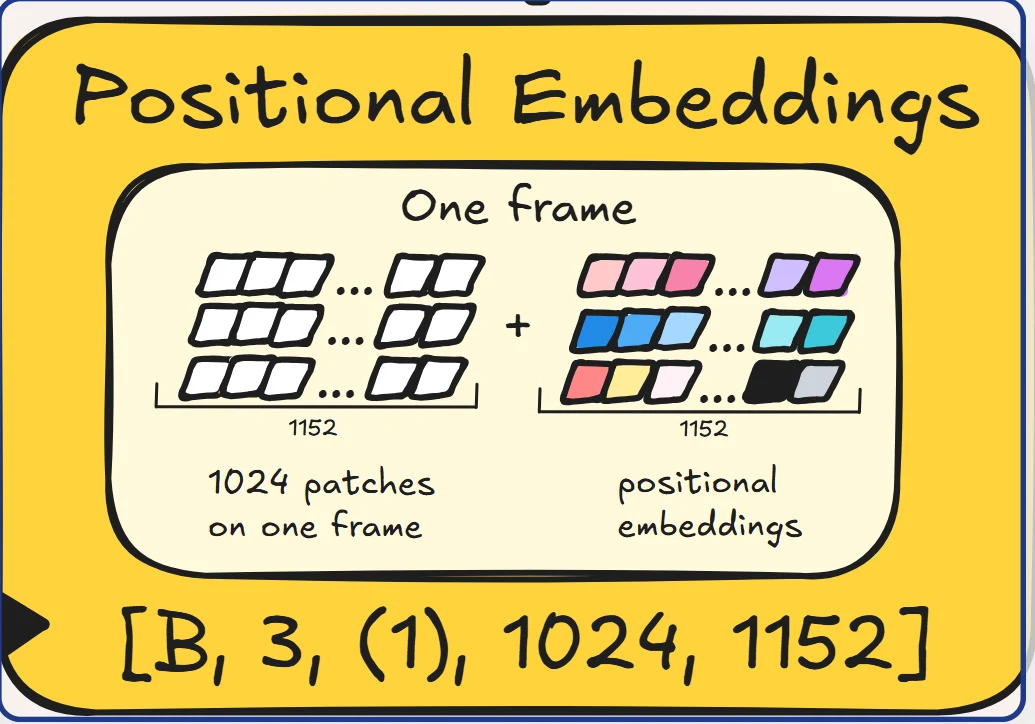
每个视觉 patch 都会获得空间位置编码,用于表示它在目标图像中的位置。
Subgoal tensor
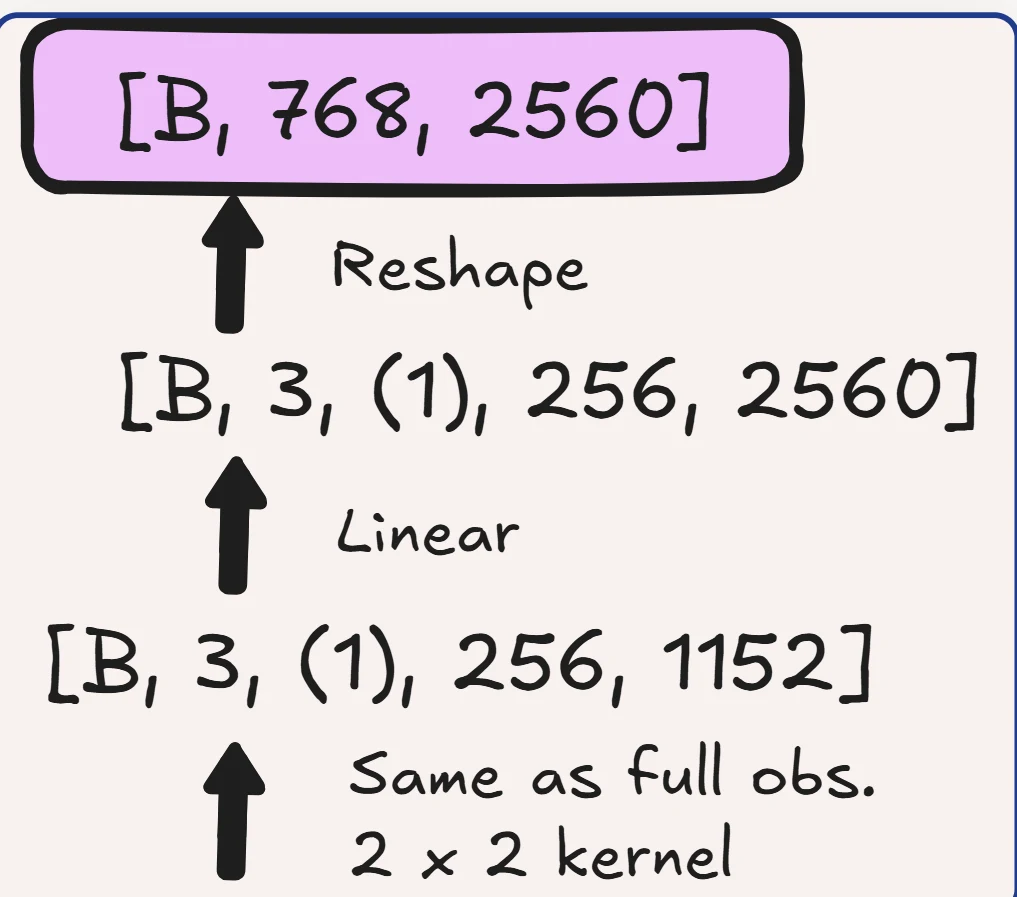
经过 pooling 和 projection 后,每张目标图像被表示为 256 个宽度为 2560 的 token。
3 张目标图像合并后得到:
Text prompt
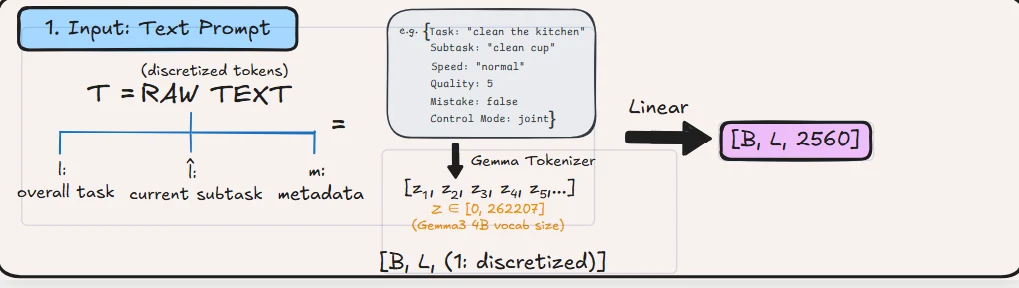
模型通过文本接收到的所有信息都会被组织成一段原始字符串,其中包含三个部分:
- :总体任务,例如“clean the kitchen”;
- :当前子任务,例如“clean cup”;
- :episode metadata。
Control mode 会被追加到文本末尾。
Gemma tokenizer 会将这段字符串拆分为 个整数 ID。每个 ID 的取值范围是 0 到 262207。
随后,embedding table 会将每个 ID 转换为 2560 个数字:
论文给出的 prompt 示例是:
“Task: peel vegetables. Subtask: pick up the peeler. Speed: 8000. Quality: 5. Mistake: false. Control Mode: joint.”
其含义是:
“<多视角观测><多视角子目标> 任务:削蔬菜。子任务:拿起削皮器。速度:8000。质量:5。错误:否。控制模式:joint。<本体感觉>”
在完整输入序列中:
- image token 位于最前面;
- 随后是文本 prompt;
- 最后是关节位置 token。
Task、subtask 与 metadata
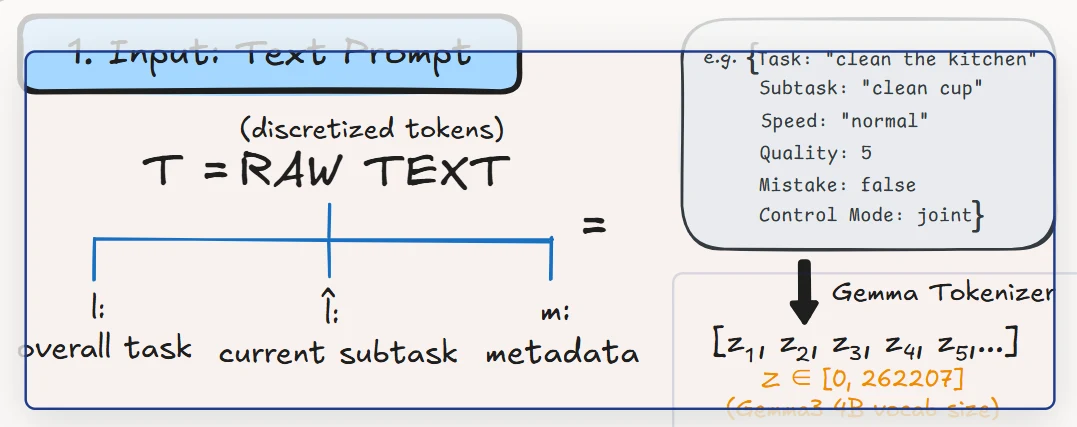
文本 prompt 至少包含:
- 总体任务;
- 当前子任务;
- 速度;
- 质量;
- 是否出错;
- 控制模式。
这些内容使模型可以区分不同质量、不同速度和不同控制条件下的行为。
Gemma tokenizer
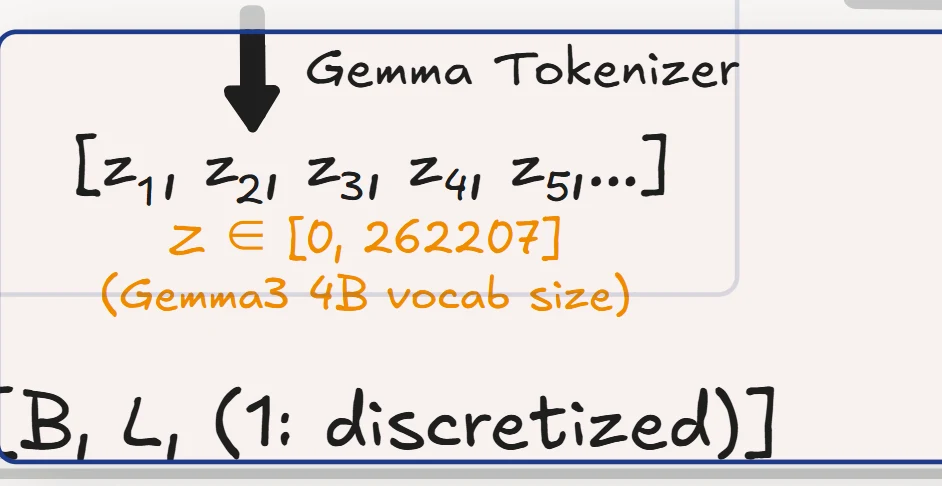
Gemma tokenizer 将原始字符串转换为整数 token ID。
每个 ID 位于:
之间。
随后,embedding lookup 将每个 ID 转换为宽度为 2560 的向量。
Text tensor
最终的文本 tensor 为:
其中 取决于任务描述、子任务描述和 metadata 的长度。
Proprioception
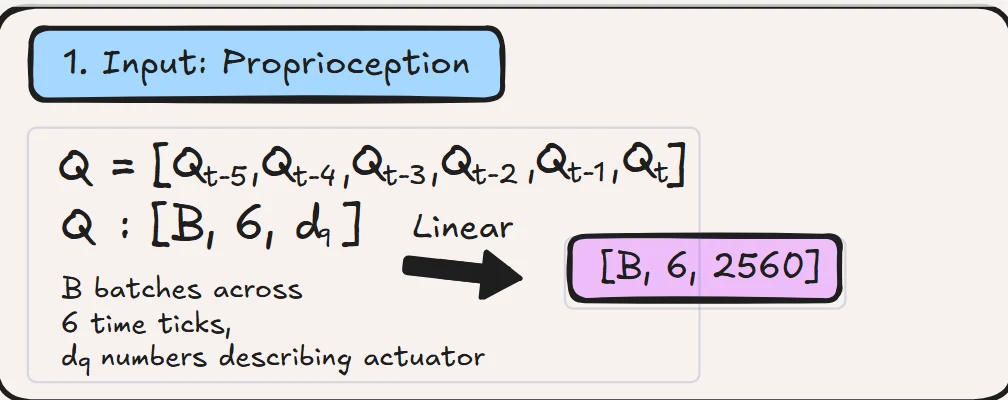
Proprioception 是机器人感知自身身体状态的能力,主要包括:
- 关节角度;
- 夹爪开合程度。
模型接收与相机帧相同的 6 个时间步上的状态:
其 shape 为:
其中, 是该机器人包含的状态值数量。
一个 linear layer 会将每个状态映射为 2560 个数字,从而每个时间步得到一个 token:
π0.6 曾经将状态转换为文本 token。由于用文本表达 6 个状态会消耗大量 token,π0.7 遵循 MEM 的方法,直接使用 projection。
训练过程中,当历史图像被删除时,与这些图像对应的状态 token 也会被一并 mask。
State history
状态序列为:
其中每个时间点的状态包括机器人各关节的位置以及夹爪状态。
Proprioception tensor
经过 linear projection 后,得到:
每个时间步对应一个 token。
Together
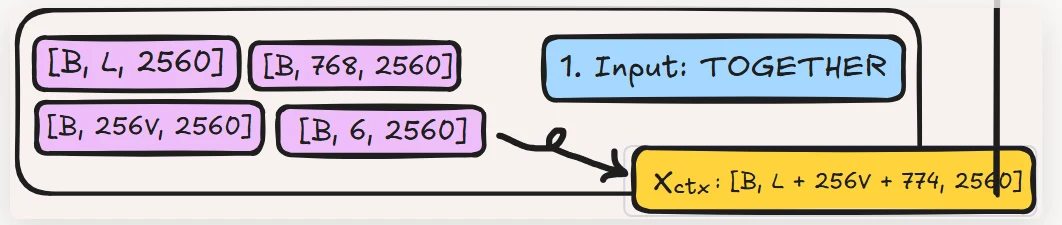
四类输入沿 sequence axis 连接为一个统一 tensor:
- observation:
- subgoal images:
- text:
- proprioception:
最终得到:
其中:
后续架构图将这一长度记为 :
在这一阶段,tensor 主要由图像 patch 组成,文本和状态作为其他模态被追加到序列中。经过 backbone 的 attention layer 后,每个图像 token 都会携带来自文本和状态的信息。
如果某一部分 prompt 被删除,对应的 token 也会从输入中移除, 会相应缩短。
在不包含 subgoal images 的 75% 训练样本中,768 个 subgoal token 不会出现。
Context tensor
统一 context tensor 为:
其中:
这一 tensor 会被送入 Gemma 3 backbone,并作为后续动作生成的共同上下文。
Decision model
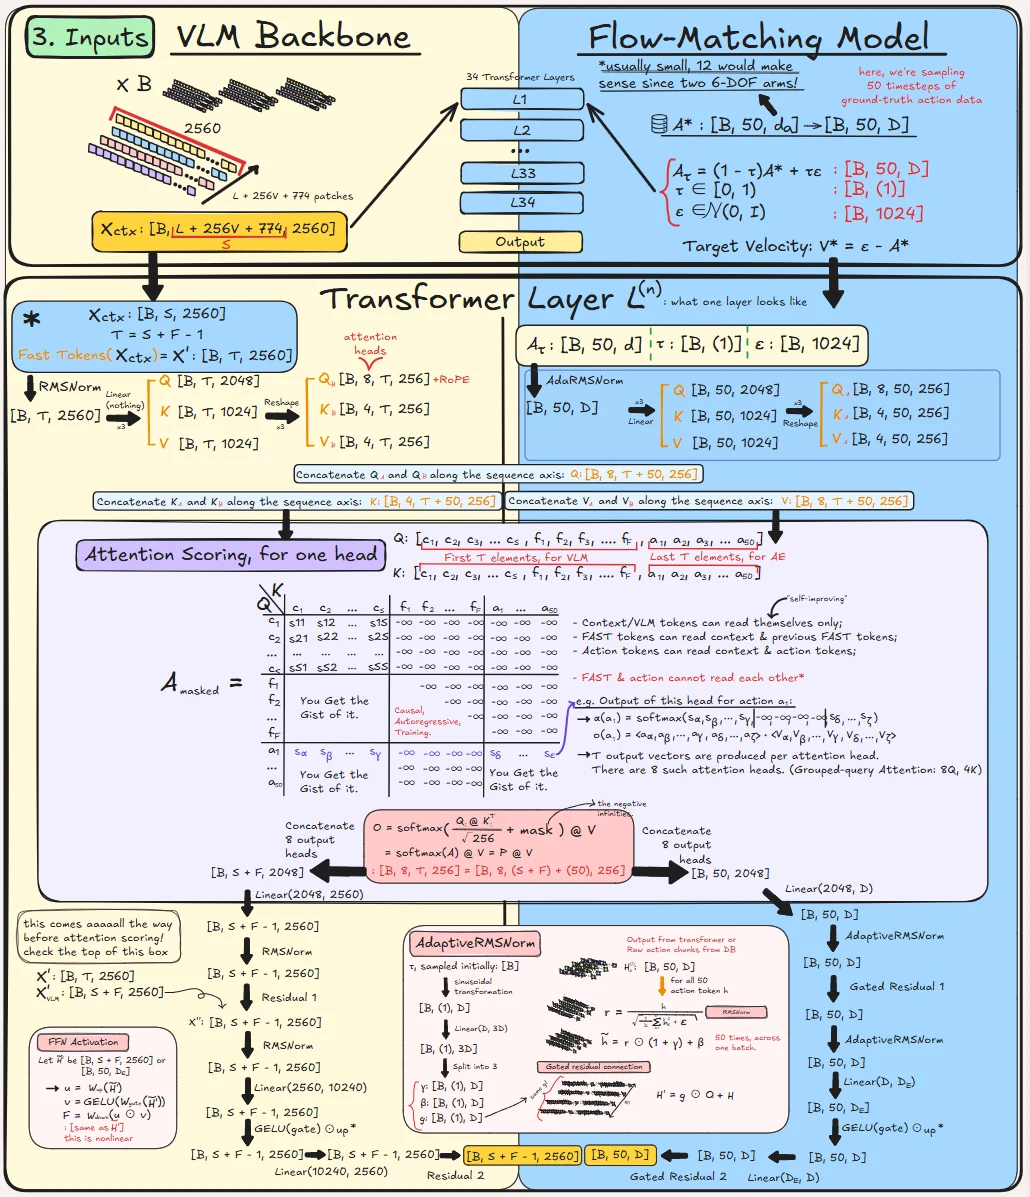
Decision model 将 转换为 50 个动作。它由两个并列的 Transformer 组成:
- VLM backbone(左侧,黄色):Gemma 3 4B,一个预训练的视觉语言模型,拥有 34 层,每层宽度为 2560。它读取 。
- Action Expert(右侧,蓝色):一个拥有 8.6 亿参数的较小 Transformer。它读取 50 个带噪声的动作 token,并通过 Flow Matching 学习如何将噪声转换为干净的 action chunk。
两个模块使用独立的参数,但在每一层共享一次 attention operation。在第 层中,动作 token 会读取 backbone 在第 层计算出的 keys 和 values。动作因此能够看到图像和 prompt 中的信息。下方的“Transformer Layer ”面板展示了其中一层的结构。
画布标题是“One Forward Pass (two, really)”,即“一次前向传播——严格来说是两次”。
训练时,一次 forward pass 会同时计算两个模型。运行时,backbone 只对 context 运行一次,并保存其 keys 和 values;随后,Action Expert 每个 denoising step 运行一次,共运行 5 次,每次都读取已经保存的 context。
在一张 H100 GPU 上,完整模型的响应时间为 38 到 127 ms,具体取决于是否使用历史信息和 subgoal images。
VLM backbone · X_ctx
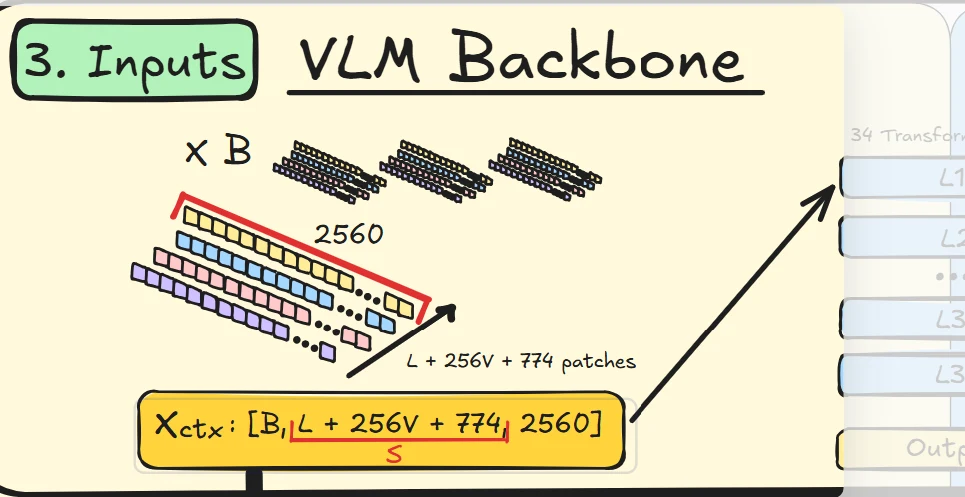
Gemma 3 预训练于来自互联网的图像和文本。它已经知道什么是杯子、杯子位于图像中的什么位置,以及“上方的柜子”指的是什么。
但它并不一定已经学会这些观测与机器人 50 步电机轨迹之间的精确关系。
该面板展示 backbone 的输入: 个序列,每个序列长度为:
每个 token 的宽度为 2560。
整个 context 记为 ,其长度记为 。箭头将它送入 34 层 backbone 中的第一层。
Flow-matching model
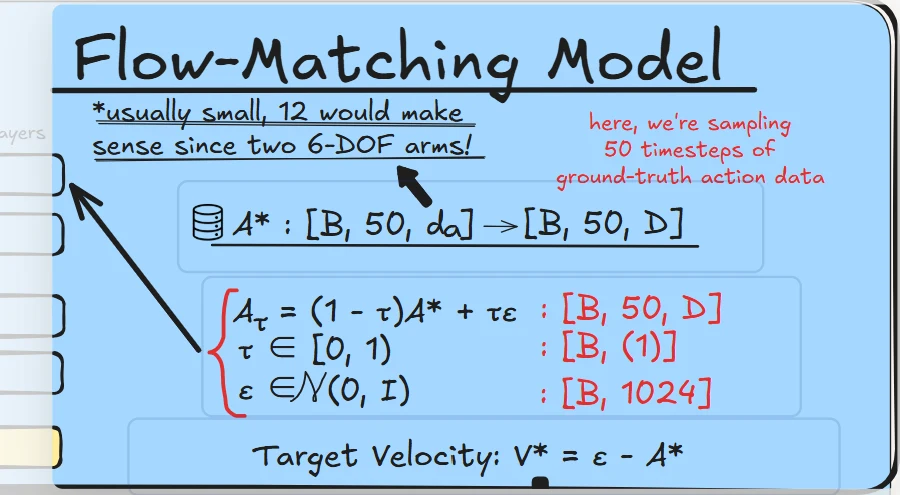
系统在这里接入一个最初未经训练的 8.6 亿参数 Action Expert。
Action Expert 一次性生成完整的 action chunk,即接下来的 50 个动作。
它使用 Flow Matching 进行训练。对于一个训练样本,系统先取真实动作 chunk ,再按照比例 将它与 Gaussian noise 混合,并要求 Action Expert 判断,从当前混合状态返回数据分布应该沿哪个方向运动。
运行时,Action Expert 从纯噪声开始,沿着自己预测的方向经过 5 个步骤,得到干净的 action chunk。
使用 Flow Matching,而不是直接预测一个固定答案,是因为完成同一个任务通常存在多种正确动作。如果模型被训练去预测这些动作的平均值,最终生成的轨迹可能不符合其中任何一种真实动作。像图像生成模型一样生成一个样本,可以避免这个问题。
π0.7 还针对 real-time chunking 进行训练。机器人继续运动时,Action Expert 在后台计算下一段动作。模型会接收当前 action chunk 已经执行的部分,并生成与正在执行轨迹连续衔接的新 chunk。
Action chunk
是 ground-truth action chunk,即从记录的 episode 中连续截取的 50 个动作,每个动作由 个数字组成。
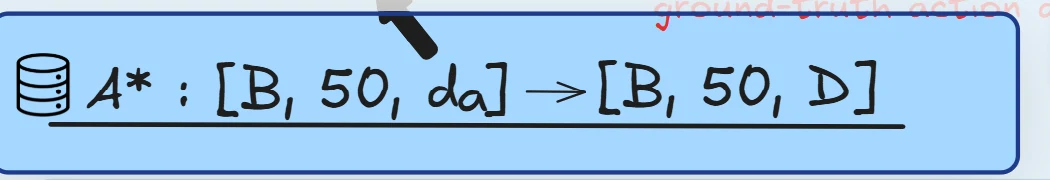
在论文使用的 50 Hz 机器人上,50 个动作覆盖 1 秒的运动;UR5e 机械臂的控制频率为 20 Hz,因此在 UR5e 上,一个 action chunk 覆盖 2.5 秒。
一个 linear layer 会将每个动作扩展到 Action Expert 的宽度:
每个动作对应一个 token。
图中说明: 图中似乎假设两台机械臂各有 6 个关节,因此 。但论文中的双臂机器人还为每条机械臂配备了一个 1-DoF 夹爪,因此动作维度应为 14;移动机器人还会增加升降轴和底盘轴。
π0 和 π0.5 会将所有机器人的动作补齐到统一宽度。在它们的开源版本中,这一共享宽度为 32,因此同一个模型可以服务于不同机器人。
Noise & flow time
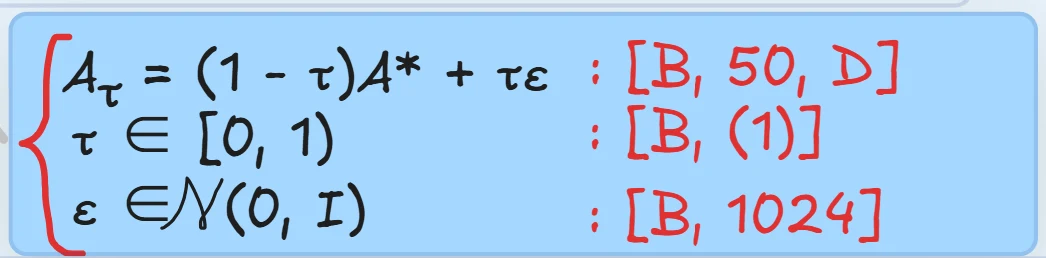
带噪声的输入为:
其形状为:
- 是 flow time,即每个样本对应一个数值:
当 时,输入是干净的 action chunk;当 时,输入是纯噪声。
- 是均值为 0、方差为 1 的 Gaussian noise,其形状与 action chunk 相同:
图中说明: 图中以及 Transformer panel 中将 标记为 。但噪声必须与 action chunk 具有相同的形状,即 ,因为它会逐元素加到 上。
Target velocity
Target velocity 为:
它是 关于 的导数,表示当 从 0 增长到 1 时,带噪声 action chunk 移动的方向。
Action Expert 学习根据 、 和 context 预测 。
运行时,采样过程会沿着这条路径反向执行:
- 从 的纯噪声开始;
- 进行 5 次步长为 0.2 的更新;
- 每一步执行:
- 直到 ,得到最终的干净 action chunk。
L1
VLM backbone 由 34 个结构相同的层组成,图中依次标记为 L1 到 L34。
L1 直接接收 。训练时,经过 embedding 的 FAST action token 还会追加到输入中,具体过程见 VLM Loss 部分。
Action Expert 也有自己的一组层。在 π0 系列模型中,每个 Action Expert layer 都与 backbone 中相同深度的 layer 配对,因为 Action Expert 的 attention 会读取该层生成的 keys 和 values。
从 Flow-matching model 指向 L1 的箭头,表示 50 个动作 token 进入第一组配对层。
L2
L2 的结构与 L1 完全相同,区别只在于两者使用的参数不同。
L2 与 L33 之间的省略号代表第 3 层到第 32 层,这些层都重复相同的结构。
下方的“Transformer Layer ”面板会完整画出其中一层。
L33
每一层都会保持 tensor shape 不变:
- backbone token 的形状保持为 ;
- Action Expert token 的形状保持为 。
不同层之间发生变化的,是每个向量所编码的内容。
L34
L34 是最后一层。
它的输出,也就是图中的黄色“Output”框,会分成两条路径:
- backbone 在 FAST token 位置上的向量进入 vocabulary projection,并用于计算 VLM Loss;
- Action Expert 的 50 个向量进入 ,生成 EAM Loss 所需的 predicted velocity。
Transformer layer
该面板展开了 34 层中的一层。
左半部分用黄色表示,使用 backbone 的参数;右半部分用蓝色表示,使用 Action Expert 的参数。二者只在中间的 attention 部分发生交互。
每一层包含以下步骤:
- Project 两侧分别对自己的 token 进行归一化,并将它们投影为 queries、keys 和 values:
- Concatenate backbone 的 个 token 与 Action Expert 的 50 个 token 拼接为一个长度为 的序列。
- Attend, with a mask 在拼接后的序列上执行一次 attention operation。attention mask 决定每个 token 可以读取哪些其他 token。
- Split attention 输出重新切分为 backbone 的 行和 Action Expert 的 50 行。随后,两侧分别使用自己的 output projection、residual connection 和 feed-forward network。
由于 mask 决定了哪些 token 可以读取哪些 token,同一套层结构可以同时承担三种作用:
- context 读取 context;
- FAST token 以文本形式预测动作;
- action token 读取 context。
训练时,backbone 序列长度为:
即 个 context token 加上 个 FAST token 中除最后一个之外的其余 token。这里的 会在 VLM Loss 部分解释。
需要注意,架构图中有些标签写成了 ,但实际应理解为:
例如 attention 后的 tensor 应为:
而不是 。
Attention 的输出形状为:
而不是:
。
拼接后的 values 形状为:
因为 values 使用 4 个 head,与 keys 的 head 数量相同。
FAST tokens / X_ctx
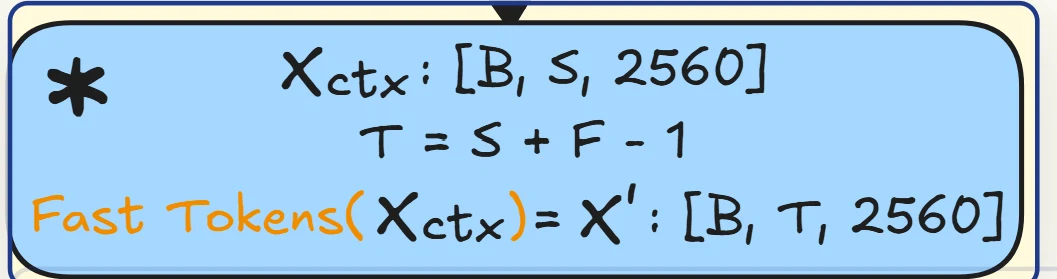
这是 backbone 进入当前层的输入。
在第 1 层中,它首先是:
随后追加经过 embedding 的 FAST token,得到:
其中:
在后续层中,它是上一层的输出,形状保持不变。
Context queries、keys 与 values
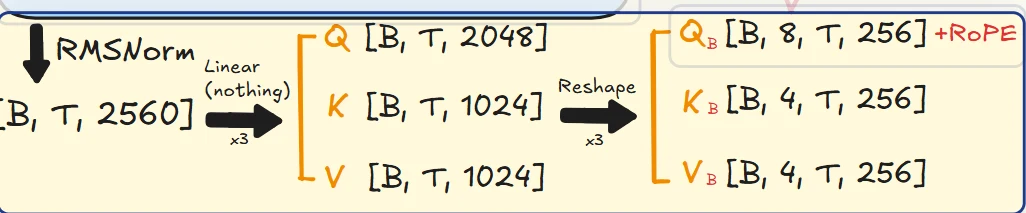
RMSNorm 会将每个 token 重新缩放到标准大小。随后,三个 linear layer 分别生成:
- queries:
- keys:
- values:
这些 projection 都不包含 bias term。
接下来,将宽度划分为每个 256 个数字的 attention head:
- 8 个 query heads:
- 4 个 key heads 和 value heads:
这是一种 grouped-query attention:每个 key-value head 由 2 个 query heads 共享,从而将 keys 和 values 所需的 memory 减半。
Gemma 3 还会在执行 RoPE 之前,对每个 query 和 key vector 进行归一化,即 QK-norm。图中省略了这一过程。
Action queries、keys 与 values
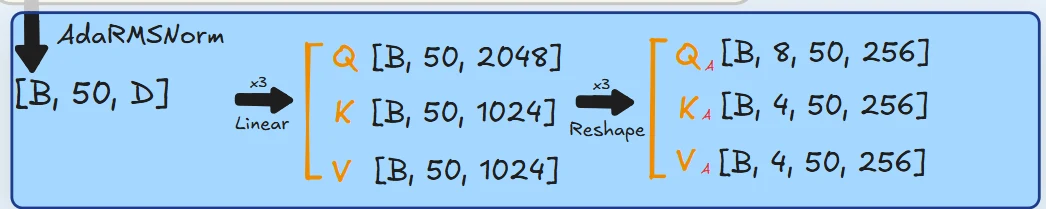
Action Expert 使用自己的参数执行相同的过程。
在第 1 层中,它的输入是 ,随后被 projection 到宽度 。在后续层中,输入则是上一层的输出。
输入首先经过 AdaptiveRMSNorm 归一化。该模块会注入 flow time ,具体见下文的 AdaptiveRMSNorm 部分。
Action Expert 的 projection 输出为:
以及:
Action Expert 必须使用与 backbone 完全相同的 head 数量和 head 宽度。否则,它的 queries 就无法与 backbone 的 keys 进行比较,两个序列也无法拼接。
RoPE
RoPE,即 rotary position embedding,会按照与 token 在序列中的位置成比例的角度,旋转每个 query vector 和 key vector。
旋转之后,两个 token 之间的 score 取决于它们相距多远。这样,backbone 不需要向输入中额外添加位置向量,也能知道 token 的顺序。
Sequence concatenation

backbone 和 Action Expert 的 projection 沿 sequence axis 拼接:
从这里开始,直到之后重新 split,attention 都将以下内容视为一个序列:
- 个 context 和 FAST token;
- 50 个 action token。
前 个位置属于 backbone,即图中的“first elements, for VLM”。
最后 50 个位置属于 Action Expert。图中写作“last elements, for AE”,但这里应理解为“last 50”,因为 Action Expert 只有 50 个 action token。
Attention mask
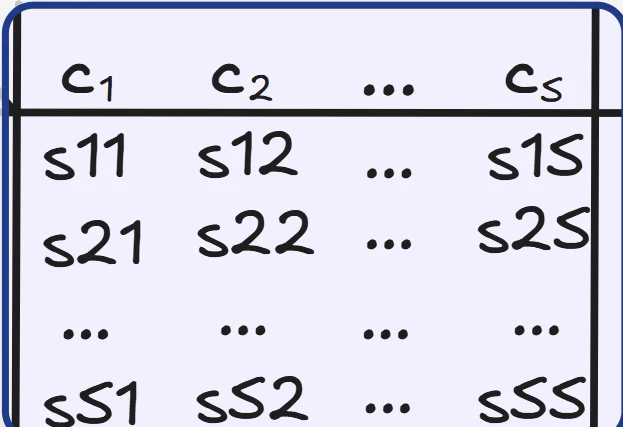
对于一个 attention head,attention 会将每个 query 与每个 key 进行比较:
得到一个大小为:
的 score table,并按照:
进行缩放。
Mask 会向所有不允许读取的 token pair 加上 。经过 softmax 后,这些位置的权重就会严格等于 0。
图中的表格就是这一 mask:
- 行表示读取者,即 queries;
- 列表示被读取的对象,即 keys。
Context token
Context token 只能读取 context。
它们不能依赖 FAST token 或 action token,因为这些 token 编码的是答案。
FAST token
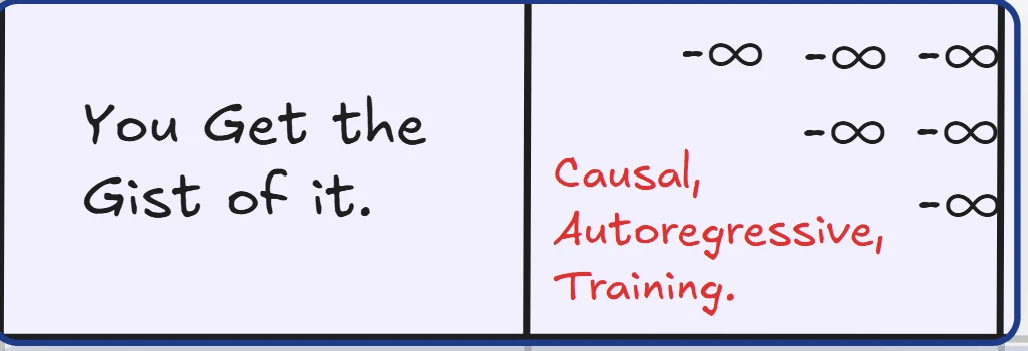
FAST token 可以读取:
- context;
- 更早的 FAST token。
每个 FAST token 都根据它之前的 token 进行预测,就像普通文本生成一样。
Action token
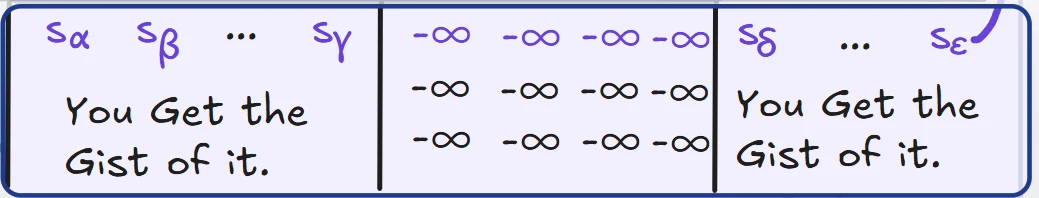
Action token 可以读取:
- 所有 context token;
- 全部 50 个 action token。
因为 action chunk 是整体生成的,所以 action token 可以双向读取彼此。
FAST token 与 action token 之间
FAST token 和 action token 永远不能互相读取。
FAST token 只在训练阶段存在,因此 Action Expert 不能依赖它们;同时,带噪声的动作中包含 ground truth,FAST prediction 也不能读取这些动作。
图中简化了 context block。论文中的实际规则是:
- observation token 可以双向读取彼此;
- subgoal token 可以读取彼此,也可以读取 observation;
- text token 和 state token 使用 causal 方式,只读取它们之前的 token。
Context attention
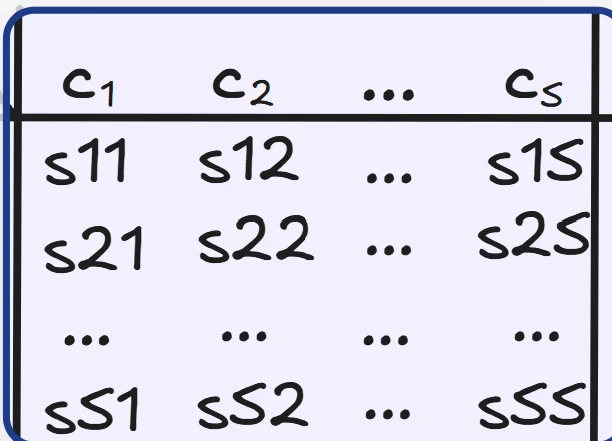
这是 attention mask 的左上角区域。
Context token 相互计算 score:
它们右侧的每一列都是 ,因此 context token 不会读取 FAST token 或 action token。
Context 的计算方式与运行时完全相同,因为运行时根本不存在 FAST token 和 action token。
FAST causal attention
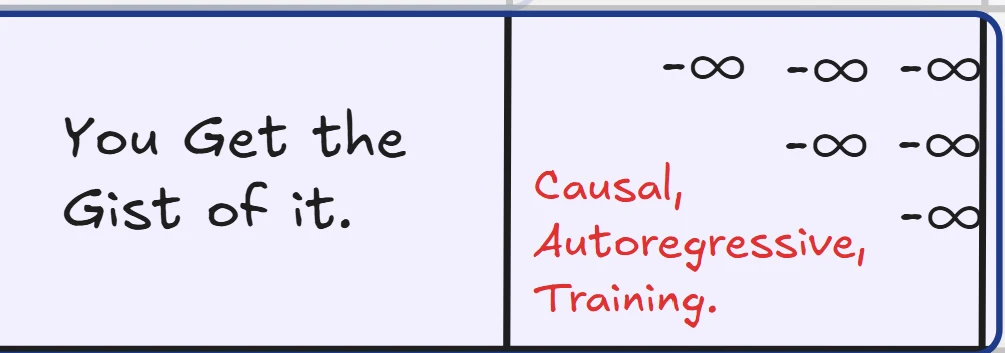
中间的行对应:
每个 FAST token 都可以读取:
- 所有 context token;
- 包括自身在内的 FAST token。
这一模式是下三角结构,表示 causal、autoregressive training。
FAST 位置 上的 vector 只能使用 token 之前的信息,因此它可以被训练为预测第 个 token。
Action attention
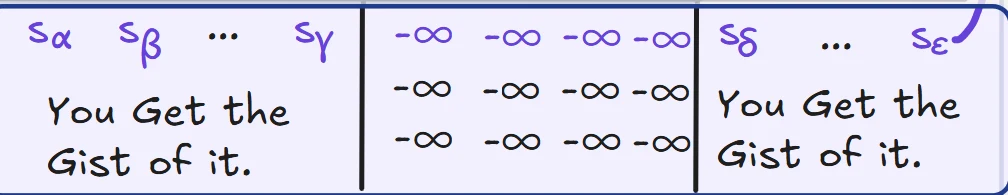
底部的行对应:
每个 action token 都可以读取:
- 所有 context token;
- 所有 action token;
- 但不能读取 FAST 列。
以 action 为例,其 attention weights 为:
对于允许读取的 key,它会产生一个概率权重;对于被 mask 的 key,权重为 0。
输出是允许读取的 value vector 的加权和:
Knowledge Insulation 还增加了一条 mask 无法表达的规则:
当 Action Expert 读取 backbone 的 keys 和 values 时,梯度会在那里停止。
因此,Flow Loss 可以改变 Action Expert 读取 context 的方式,但不能改变 context 本身。具体见 VLM Loss 部分。
Attention output
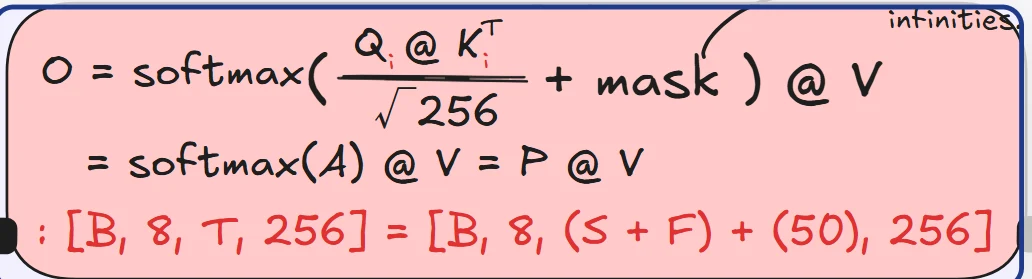
Attention 输出为:
每个 head 为每个 token 返回一个包含 256 个数字的 vector,因此结果为:
随后,输出会被重新 split。
前 行送回 backbone:
- 将 8 个 head 拼接为:
- 使用 将其映射回 backbone 宽度。
后 50 行送回 Action Expert:
- 先得到:
- 再经过:
Context residual 与 feed-forward
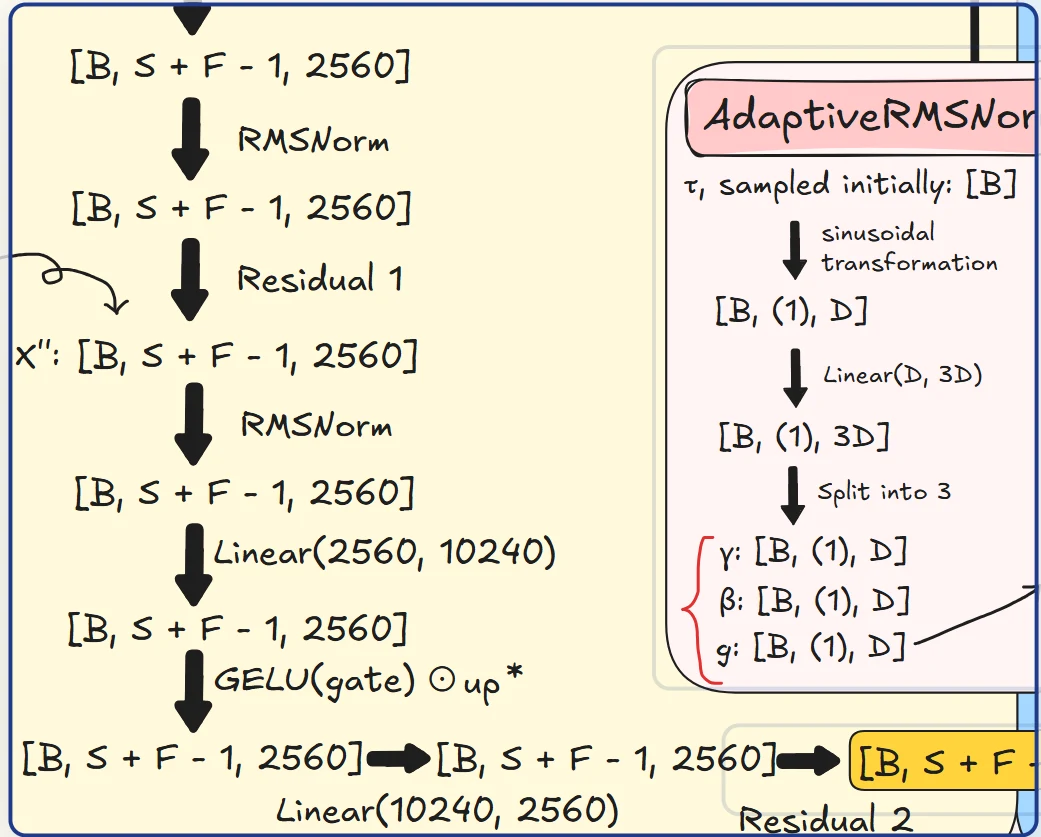
Backbone 一侧严格遵循 Gemma 3 的 layer 结构。
- 对 attention output 执行 RMSNorm,然后将其加到该层输入上,即 Residual 1,得到:
- 对 执行 RMSNorm,并经过 feed-forward network:
- 两个 ,分别作为 gate projection 和 up projection;
- 计算:
- 再经过:
- 对上述结果执行 RMSNorm,并将其加到 上,即 Residual 2。
在每个 sub-block 前后都进行归一化,是 Gemma 3 的设计。
输出形状为:
它会作为下一层的输入。
图中的注释“this comes aaaaall the way before attention scoring”指回 ,也就是在第一次 residual connection 中被加回去的 layer input。
Action residual 与 feed-forward
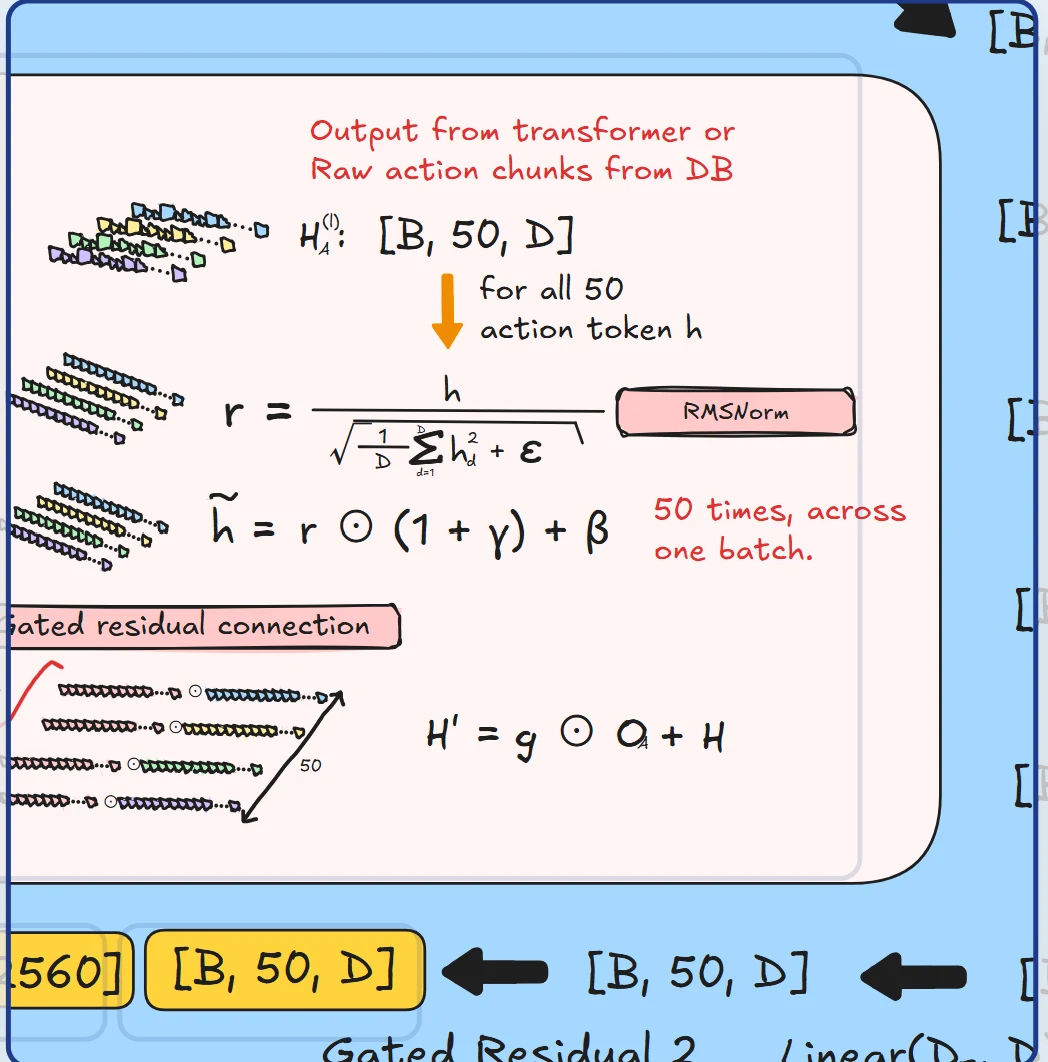
Action Expert 一侧采用相同的结构,但有三个区别:
- 它的宽度是 ;
- 它的 feed-forward width 是 ;
- 所有 normalization 都使用 AdaptiveRMSNorm,因此 flow time 会调节每个 sub-block。
具体过程如下:
- 对 attention output 使用:
- 经过 AdaptiveRMSNorm;
- 执行 Gated Residual 1;
- 再次经过 AdaptiveRMSNorm;
- 使用 分别生成 gate 和 up;
- 计算:
- 使用:
- 执行 Gated Residual 2。
输出为:
并进入下一层的 Action Expert 分支。
AdaptiveRMSNorm
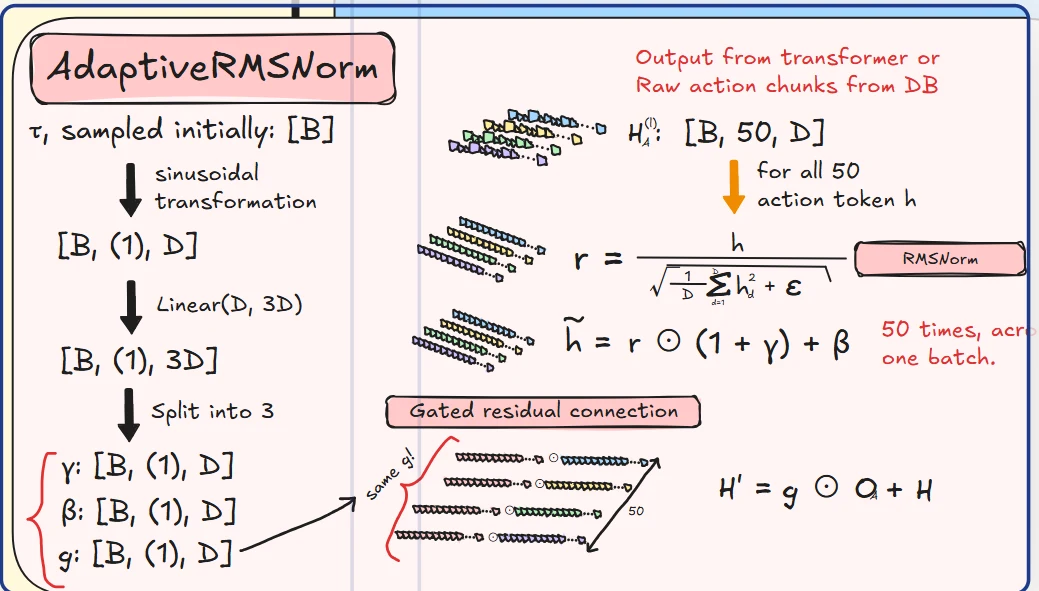
Action Expert 必须在不同噪声水平下采取不同的行为:
- 当 接近 1 时,输入几乎是纯噪声;
- 当 接近 0 时,输入已经接近最终动作。
AdaptiveRMSNorm 会将 注入每一层。
是每个样本对应的一个数值。它首先被扩展为一个正弦向量:
随后经过:
输出被切分为三个 vector:
- scale ;
- shift ;
- gate 。
三者的形状都是:
对于每个 action token ,先执行 RMS normalization:
再进行调制:
某个 sub-block 根据 计算输出 后,gated residual 会将它加回输入:
、 和 只依赖于 ,因此同一个样本中的全部 50 个 action token 共享它们。
也就是说,50 个 action token 使用相同的 gate:
“same !”
RMS 公式中的 是防止除零的极小常数。它不是 Flow Matching 中的噪声 。
FF Activation
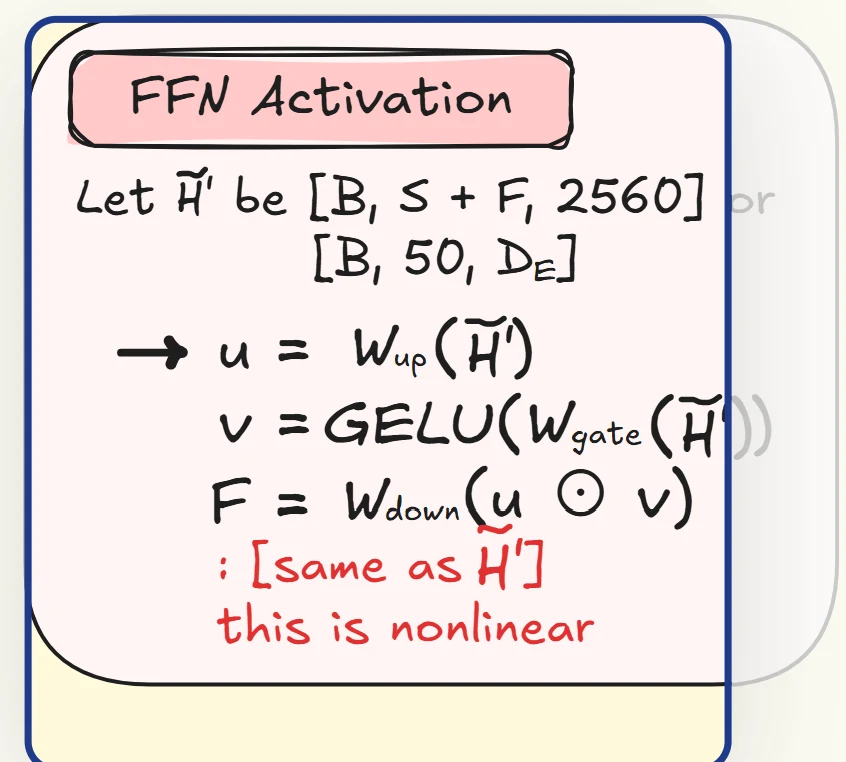
Feed-forward network 是一个 gated GELU unit,也叫 GeGLU。backbone 和 Action Expert 两侧都使用这一结构。
对于输入 :
其中, 表示逐元素乘法。
GELU 使 layer 具有非线性,而两个 projection 的乘积允许其中一个 projection 决定另一个 projection 的信息有多少可以通过。
与 具有相同的形状:
- backbone 一侧:
- Action Expert 一侧:
VLM output
VLM output 的形状为:
它表示经过当前 layer 后的 backbone token,并会作为下一层的输入。
经过 L34 后,FAST-token positions 上的 vector 会送入 VLM Loss。
EAM output
EAM output 的形状为:
它表示经过当前 layer 后的 action token。
经过 L34 后,这些 action token 会送入 EAM Loss。
EAM Loss
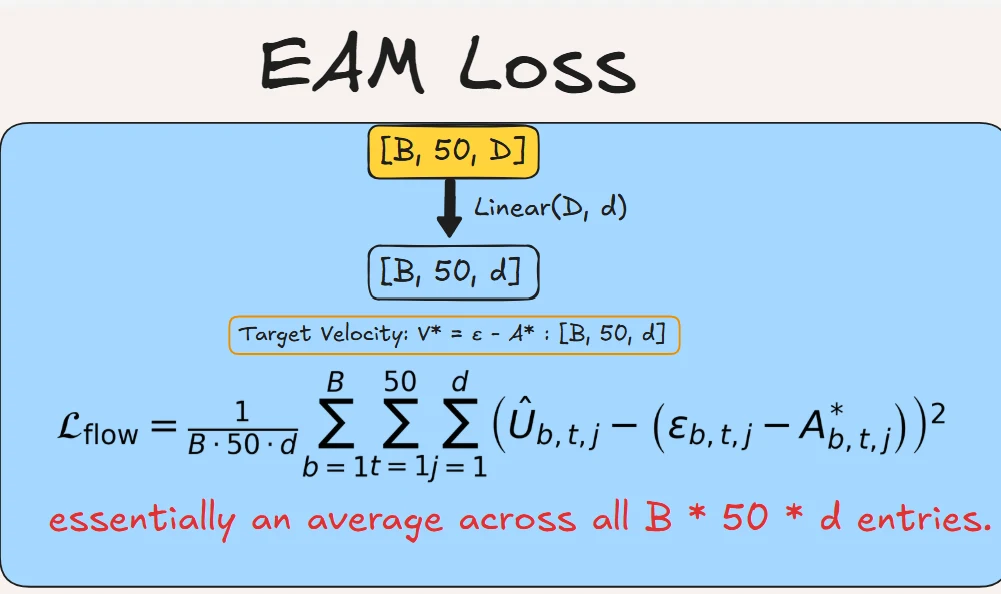
训练过程包含两个 loss,分别对应模型的两半。EAM 是 expert action model 的缩写,也是架构图中对 Action Expert 的称呼。
EAM Loss 是针对 predicted velocity 计算的 squared error。
只有 Action Expert 会从这一 loss 中学习。Knowledge Insulation 部分所描述的 stop-gradient 会阻止这一 loss 更新 VLM backbone。
Linear(D,d)
经过 L34 后,50 个 action token 中的每一个都具有 个数字。
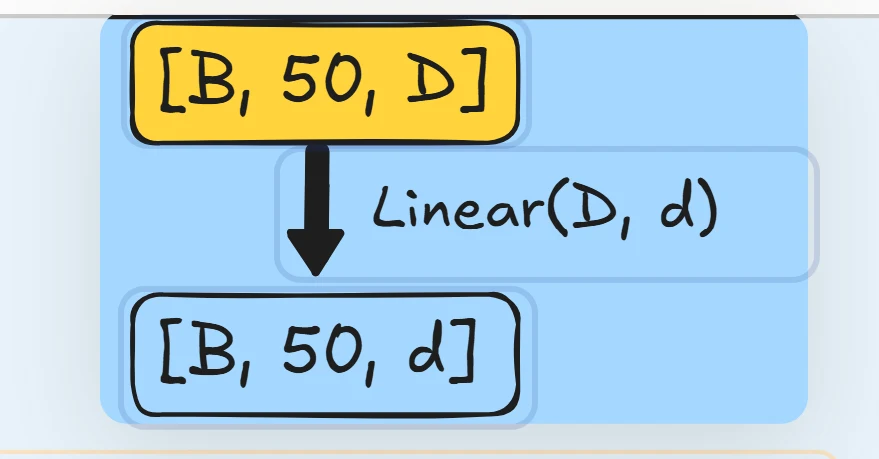
一个 linear layer 将每个 token 映射回动作本身的维度 ,得到 predicted velocity:
[B,50,D]
这是最后一层 Action Expert 的输出。每个 action token 对应一个长度为 的向量:
Linear(D,d)
分别处理每个 action token。它可以看作输入 projection 的逆过程:输入 projection 将每个动作从 维扩展到 维,而这里再将其映射回 维。
[B,50,d]
输出为:
即 predicted velocity 。
它与目标 velocity 具有完全相同的形状,因此二者可以逐元素比较。
Flow loss
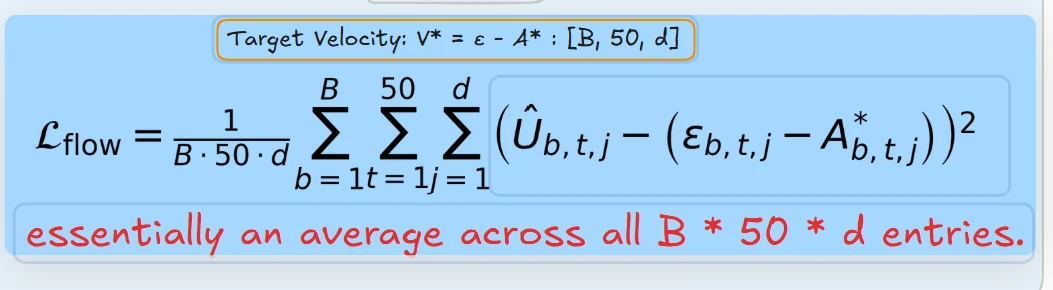
Flow loss 对 predicted velocity 与目标 velocity 之间的差异计算平方,并在全部 个元素上取平均。
目标 velocity 为:
因此,Flow loss 可以写为:
接下来,假设模型只优化:
此时有两种选择。
选项 A:允许 Flow Matching 的梯度进入 Gemma
最初随机初始化的 Action Expert 只能产生质量很差的 velocity prediction。
如果将这些错误通过 backpropagation 传回 Gemma,可能会破坏 Gemma 中已经具有价值的 pretrained representations。
选项 B:阻止 Flow Matching 的梯度更新 Gemma
这样可以保护 Gemma 已有的知识,但也会失去直接教会 Gemma“观测和指令如何对应机器人轨迹”的动作监督信号。
π0.7 需要同时获得这两种性质:
- Gemma 不受 Flow Loss 的破坏;
- Gemma 仍然能够通过动作相关目标进行训练。
VLM Loss 同时提供了这两点。
Target Velocity: V^=ε-A^
Target velocity 为:
其形状为:
这里重新使用了生成带噪声输入 时所使用的同一个 ,因此每个样本的 target 都是精确已知的。
Squared error
对于每一个样本 、动作时间步 和动作维度 ,误差为:
平方操作会使所有误差变为正值,并且相比小误差,它会对大误差施加更强的惩罚。
Average across B×50× d
Flow loss 为所有 squared error 的平均值:
也可以理解为:
“本质上是在全部 个元素上取平均。”
在 real-time chunking 训练中被排除的动作不会参与这一平均。具体来说,每个 action chunk 开头的前 0 到 12 个动作会被排除,因为这些动作已经作为已知的前缀提供给模型。
VLM Loss
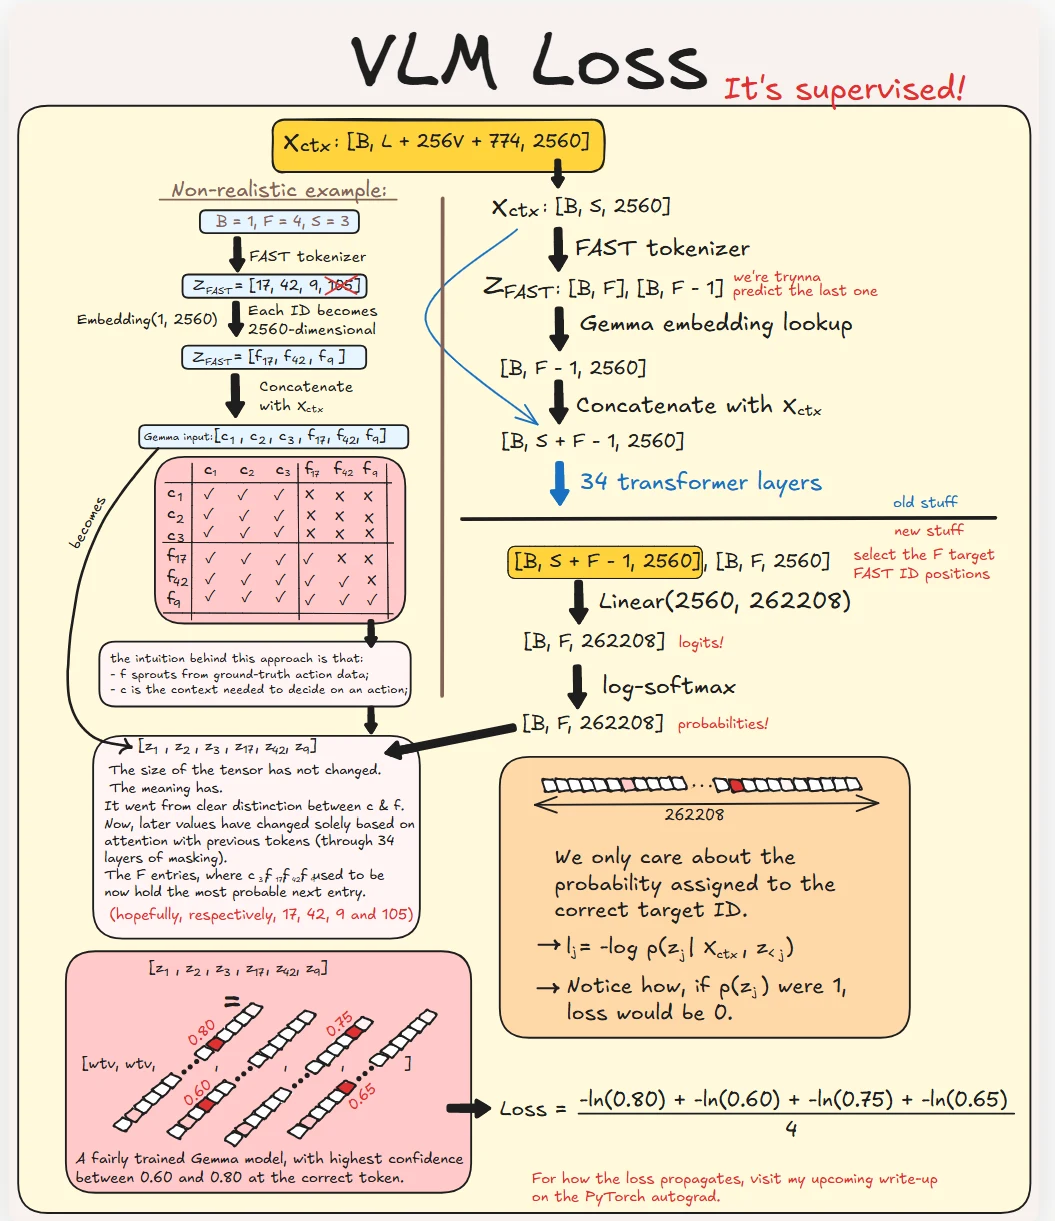
解决方案是 Knowledge Insulation。
π0.7 希望 VLM 理解机器人动作,但不希望连续 Flow Matching loss 破坏它已经学到的视觉语言知识。
Knowledge Insulation(Driess et al., 2025)结合了前面两种选择。
阻断 Flow Matching 梯度
Action Expert 可以读取 backbone 的 keys 和 values,但 Flow Loss 不会更新 backbone。
也就是说,Action Expert 能够使用 VLM 产生的 context,但 EAM Loss 的梯度不会反向进入 Gemma。
使用独立的动作监督训练 backbone
为了弥补阻断梯度所损失的动作监督,π0.7 将同一个 50 步 action chunk 写成一段离散 token,即 FAST token。
随后,backbone 使用 next-token cross-entropy 学习预测这些 token。这与 Gemma 预训练时使用的 loss 相同。
这种离散且稳定的 loss 不容易破坏 Gemma 原有的知识。
backbone 还会继续使用非机器人数据进行训练,例如:
- visual question answering;
- object localization;
- video captioning。
这些数据帮助模型保留视觉语言能力。
这里的监督信号是明确的:记录下来的机器人动作已经提供了每个 target token,因此每个 target token 都是已知的。
该部分会追踪一个训练样本如何从 转换为一个最终 loss。
FAST token 只在训练阶段存在。运行时,模型不会生成 FAST token,而是由 Action Expert 直接产生动作。
【配图建议:此处放置“Knowledge Insulation”双路径图:上方为 Flow Loss → Action Expert,下方为 FAST token → VLM Loss → backbone,并明确标注阻断的梯度路径。】
FAST tokens → Gemma input
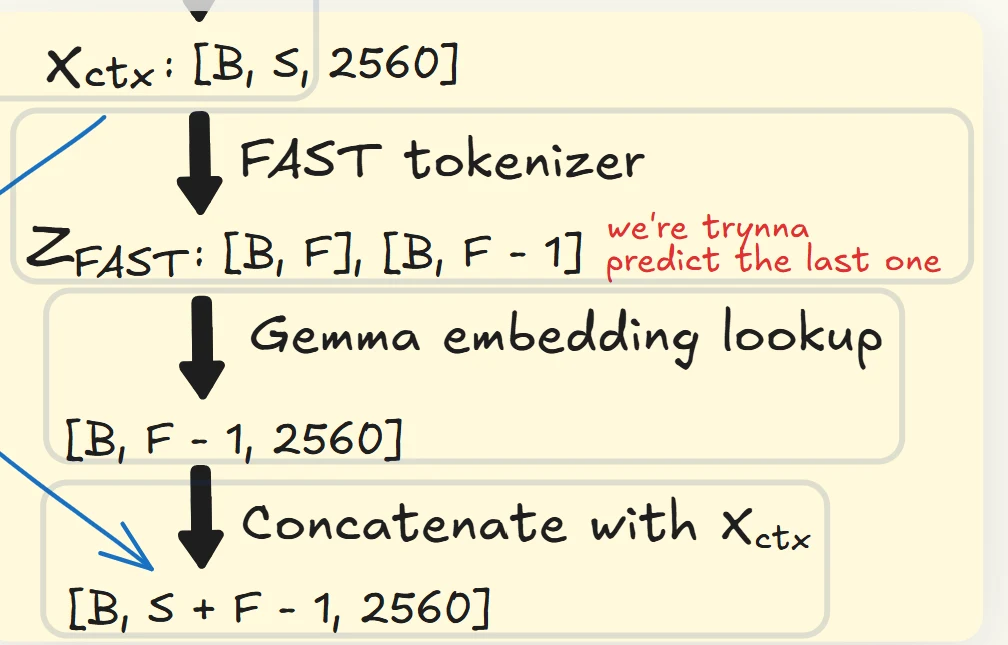
Cross-entropy 需要离散 target,例如 token ID,但机器人动作是连续数值。
FAST 解决了这个问题。
理想情况下,在任何 Transformer layer 开始之前,输入 tensor 中就已经包含 FAST token。
这就是 teacher forcing,也是训练语言模型的标准方式:
- 将真实 token 放入输入;
- 使用 attention mask,使每个 token 对应的预测位置无法读取它本身;
- 一次 forward pass 同时训练所有位置的预测。
X_ctx
是来自 context ingestion 的输入:
蓝色箭头将它送入 concatenation step,在那里,经过 embedding 的 FAST token 会被追加到 context 后面。
FAST tokenizer
FAST(Pertsch et al., 2025)会将一个 action chunk 压缩为少量整数,其方式类似于 JPEG 压缩图像。
处理步骤如下:
- 将每个动作维度归一化到统一范围;
- 对每个动作维度沿时间轴分别执行 discrete cosine transform;
- 平滑运动通常会集中在少量低频系数中;
- 将系数缩放并四舍五入为整数;
- 大部分高频系数会被舍入为 0;
- 将系数展平,按照从低频到高频的顺序排列;
- 使用 byte-pair encoding 将高频模式合并为较小的 vocabulary。
FAST 论文中的 vocabulary 包含 1024 个 token。
最终得到:
也就是一串长度为 的 token ID。
会根据动作复杂程度变化。
模型输入只使用前 个 token:
最后一个 token 不需要作为输入,因为它只需要被预测,不会再有后续 token 需要读取它。
例如,在一个非现实的示例中:
FAST token 为:
模型输入只保留:
并删除 105。
Gemma embedding lookup
每个 FAST ID 都会在 Gemma 自己的 vocabulary 中对应一个保留 ID,因此可以使用普通的 embedding table 对其进行编码。
每个 ID 会变成 2560 个数字:
图中的“Embedding ”表示:
- 输入 1 个 token ID;
- 输出一个宽度为 2560 的向量。
在上面的示例中:
会被转换为:
Concatenate with X_ctx
FAST embeddings 被追加在 context 后面:
得到:
在示例中,Gemma 输入为:
总共 6 个 token,因为:
【配图建议:此处放置 FAST token 构造流程:连续动作 → DCT → 量化 → BPE → FAST ID → Gemma embedding → 与 拼接。】
34 个 Transformer layers
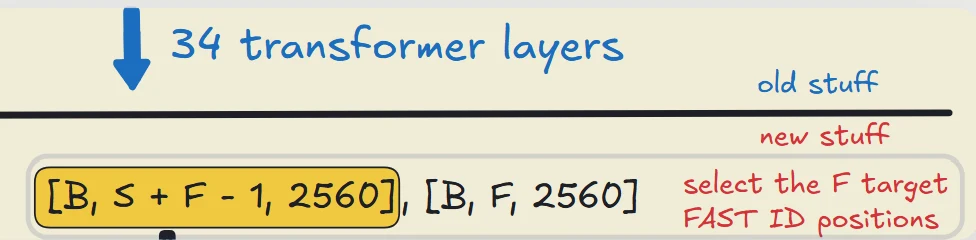
拼接后的序列会经过前面 Transformer layer 部分介绍的同一组 34 层。
架构图中标记为“old stuff”的位置,表示前面已经介绍过的部分。其下方的内容则是新的部分:如何将输出向量转换为 loss。
在这 34 层中,attention mask 允许每个 FAST 位置读取:
- 完整的 context;
- 它之前的 FAST token。
因此,经过最后一层后,每个位置上的向量都可以包含对下一个 token 的预测。
Causal attention mask
Causal attention mask 确保第 个 FAST 位置只能读取 context 和更早的 FAST token,不能读取未来 token。
F 个 target FAST ID positions
模型需要在 个目标位置上预测 FAST token。
虽然输入中只放入前 个 token,但最后一个 token 仍然对应一个预测位置。
Tensor shape 不变,但含义发生变化
经过 34 个 Transformer layer 后,tensor shape 仍然保持为:
但每个位置上的向量已经不再只是输入 embedding,而是包含了对下一个 FAST token 的预测信息。
Logits → probabilities
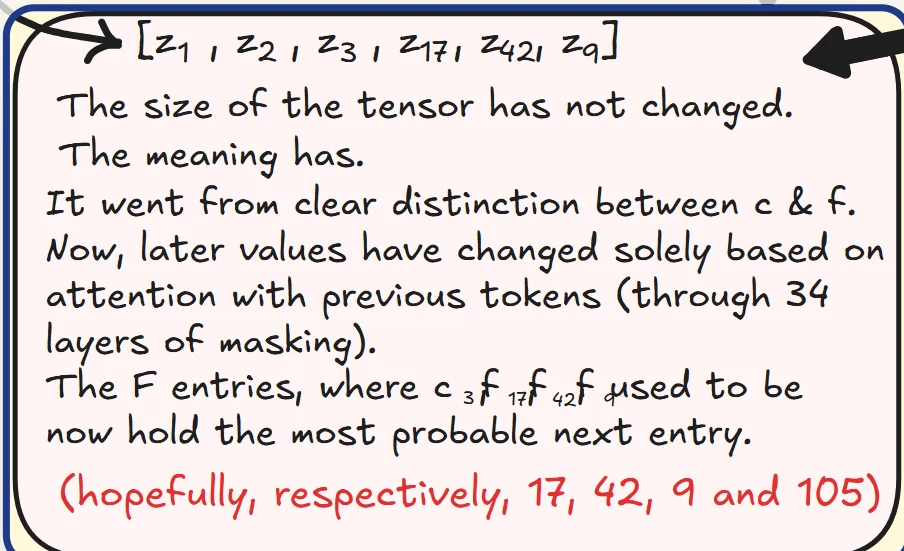
经过 34 个 Transformer layer 后,在相同的 FAST 位置上,每个向量都会被转换为一个 262208 维的向量,其中包含所有可能的下一个 token ID 的分数。
这一过程包含两个步骤:
- 通过 linear projection,为 vocabulary 中的每个 token 生成一个 score;
- 通过 log-softmax,将这些 score 转换为 log-probability。
Linear(2560, 262208)
Linear(2560, 262208) 为 vocabulary 中的每个条目生成一个 score。
Gemma 3 会复用其输入 embedding table 的转置矩阵完成这一 projection。因此,当一个 hidden vector 与某个 token 的 embedding 方向相近时,该 token 会获得更高的 score。
[B,F,262208] · logits
logits 的形状为:
它表示在 个位置上,每个可能的下一个 token 都有一个未归一化的 score。
Logits 可以是任意实数,此时它们还不是概率。
log-softmax
log-softmax 的定义为:
它从每个 score 中减去同一个常数,使所有 score 的指数之和等于 1。
最终结果是一个关于 262208 个 token 的概率分布的对数。
[B,F,262208] · probabilities
该 tensor 的形状仍然是:
其中存储的是 log-probabilities。它们都小于或等于 0。
图中将这一阶段标为“probabilities!”,但严格来说,tensor 中保存的是概率的对数。对这些值执行 exponentiation 后,才得到真正的 probabilities,并且每个位置上的概率之和为 1。
loss 直接使用对数值,因此不需要显式计算 exponentials。
Cross-entropy
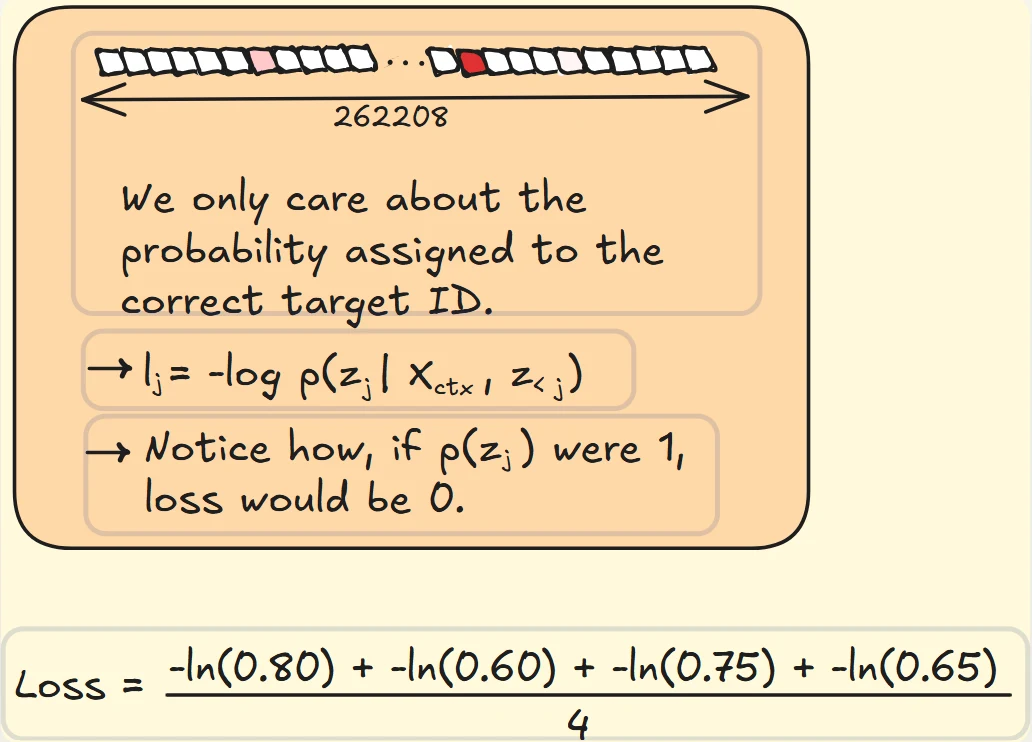
Crossentropy 将 log-probabilities 转换为一个数值,即正确 target token 的 的平均值。
当模型为正确 token 分配的概率越高时,loss 越小。
Correct target ID
在每个预测位置上,训练数据都提供一个正确的 target token ID。
-log p(z_j | X_ctx, z_<j)
表示正确 token 的负对数概率,其中条件包括:
- context ;
- 位于它之前的 FAST token,即 。
换句话说,模型根据 context 和此前已经出现的 FAST token,预测当前正确 token 。模型给正确 token 分配的概率越高, 越小。
当 p(z_j)=1 时
如果模型对正确 token 的预测概率为 1:
那么:
因此,该位置的 loss 为 0。
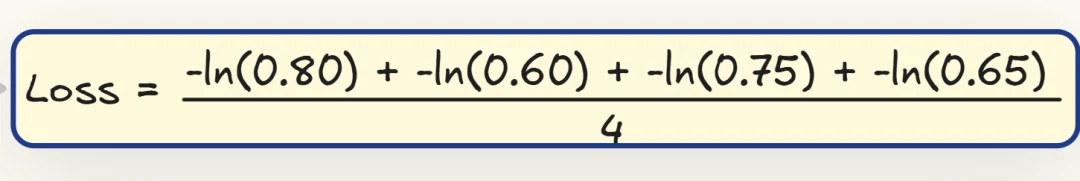
概率示例
假设 4 个位置上的正确 token 概率分别为:
那么每个位置都会产生一个对应的 loss。
Mean loss
最后,对所有 target token 的 loss 取平均,得到整体 Cross-entropy loss:
High-level policy:生成下一个子任务
这一章介绍 high-level policy,也就是决定下一步做什么的模型。
它以文本形式写出下一个子任务,例如:
“Turn on the faucet”
该文本会成为 π0.7 prompt 中的 Subtask 一行。随后,World Model 会针对这一子任务绘制目标图像。
论文只说明 high-level policy 使用与 π0.7 相同的架构。架构图中使用的是这套架构的文本部分:
- 输入图像和文本;
- 使用 next-token cross-entropy 训练模型生成下一个子任务。
这里没有 Action Expert,也没有 FAST target。
论文中的 high-level policy 是在 π0.7 基础上使用 coaching data 微调得到的。
训练时,人类会逐步告诉机器人如何执行新任务,例如:
“用左手抓住空气炸锅的把手。”
随后,模型学习自主发布这些相同的指令。
在测试的 5 个未见任务中,最终得到的自主运行结果大致能够匹配人类 coaching 的运行结果,而且没有使用新的 teleoperated action data。
运行时,子任务文本在独立线程中生成,π0.7 始终使用当前最新的子任务。
架构图复用了 low-level policy 的组件,因此可以快速浏览:
- observation 按照 Ingestion 部分的方法编码;
- loss 按照 VLM Loss 部分的方法计算。
high-level policy 的 Full observation
high-level policy 的输入只有当前帧:
这里的两个 3 分别表示:
- 3 个相机;
- 3 个颜色通道。
它不使用历史帧。机器人之前已经完成的内容,会通过文本形式提供,即已经完成的子任务列表。
Current frame · three cameras
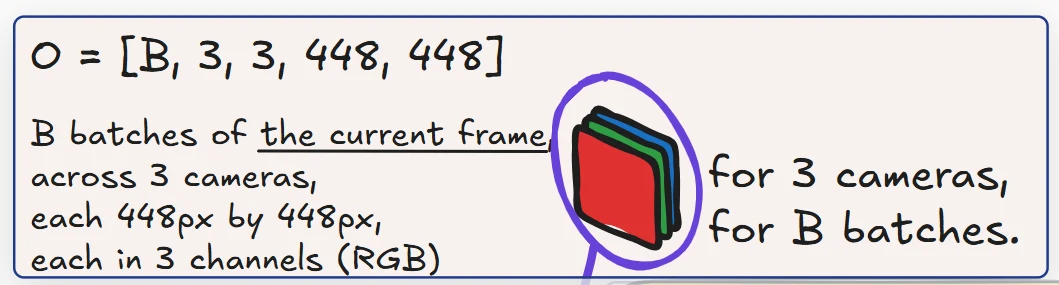
输入包含:
- 个样本;
- 3 个相机;
- 每个相机 1 帧;
- 每帧大小为 ;
- RGB 三个颜色通道。
Patchification
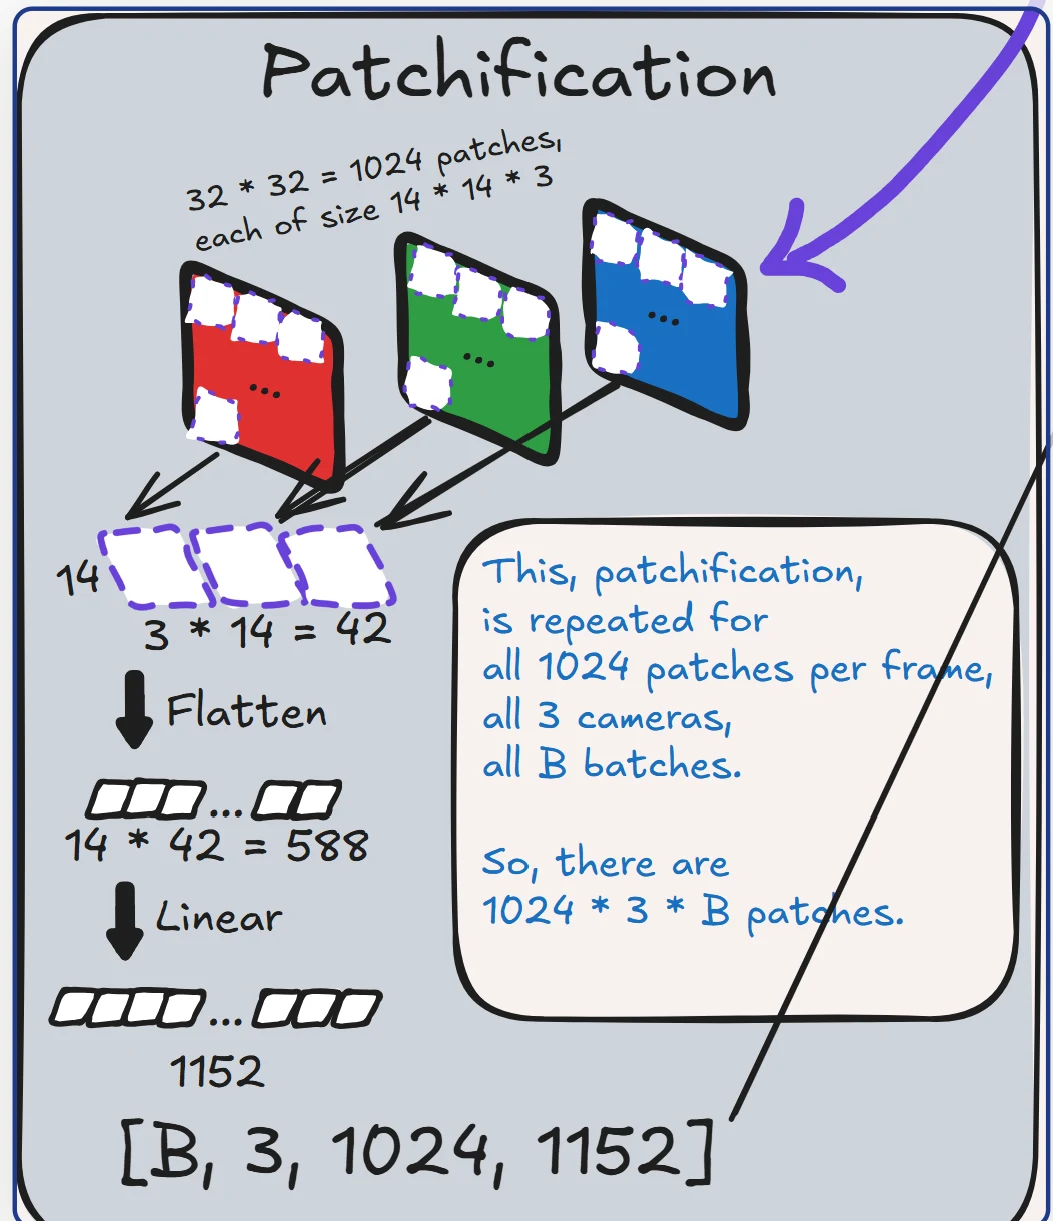
每张图像被划分为:
个 patch。
每个 patch 包含:
个数值。
通过:
将每个 patch 映射为宽度为 1152 的 token。
因此,输出为:
总共有:
个 patch。
Positional embedding
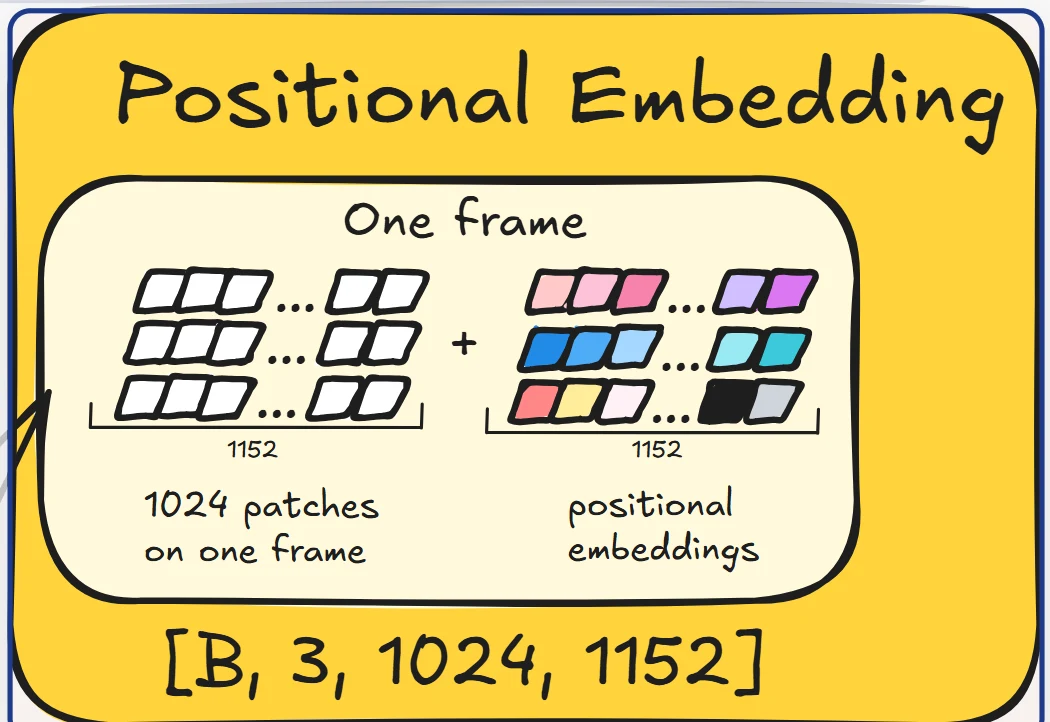
SigLIP 的 learned positional embedding 会被加到视觉 token 上。
每个网格位置对应一个由 1152 个数字组成的向量。
由于这里只包含单帧,因此不需要 time embedding。
为了送入 encoder,系统会将相机维度移动到 batch 维度:
Visual encoding
high-level policy 使用与 low-level model 相同的 SigLIP encoder:
- 27 个 Transformer layers;
- 每一层执行 spatial attention;
- 每个 token 读取同一张图像中的其他 token;
- 由于只有一帧,因此不执行 temporal attention。
输出经过 pooling 后,每张图像得到 256 个 token,再映射到宽度 2560。
最后将三个相机的 token 拼接起来:
页面图中的标签:
沿用了 low-level model 的绘图标签。这里 high-level policy 的真实 encoder 输入是:
因为每个相机只有一帧。
SigLIP · 27 Transformer layers
输入依次经过 SigLIP 的 27 个 Transformer layers。
Spatial attention
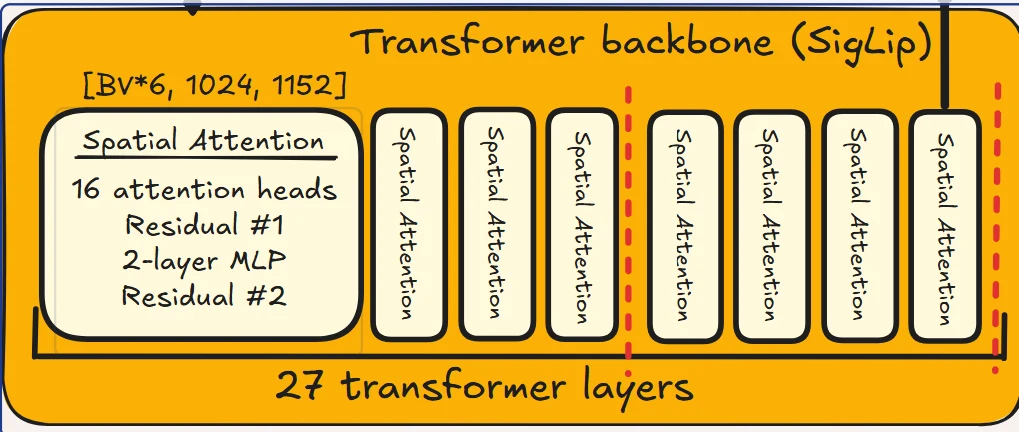
每个 token 只能读取同一张图像中的其他 token。
相机之间的信息在后续 context 拼接和 Gemma backbone 中交互。
Average pooling
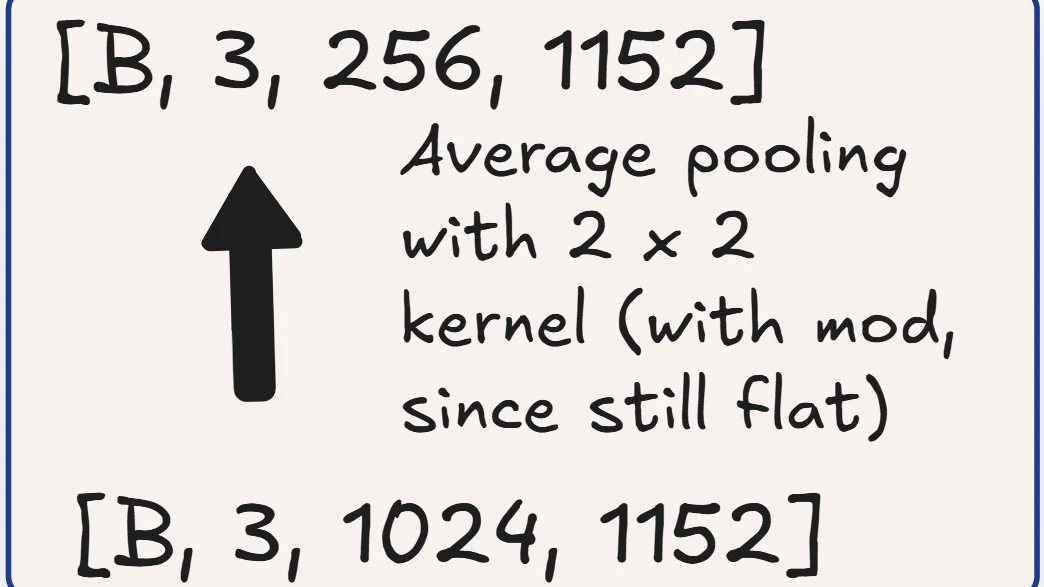
每个 的 patch 区域被平均为一个 token:
Linear(1152,2560)
每个视觉 token 被映射为宽度 2560,以便与 Gemma 3 backbone 的输入保持一致。
Flatten camera tokens
三个相机的 token 被沿 sequence axis 拼接:
【配图建议:此处放置 high-level policy 的三相机编码图,展示三张当前图像如何经过 SigLIP、pooling 和 projection 后拼接。】
Text modalities
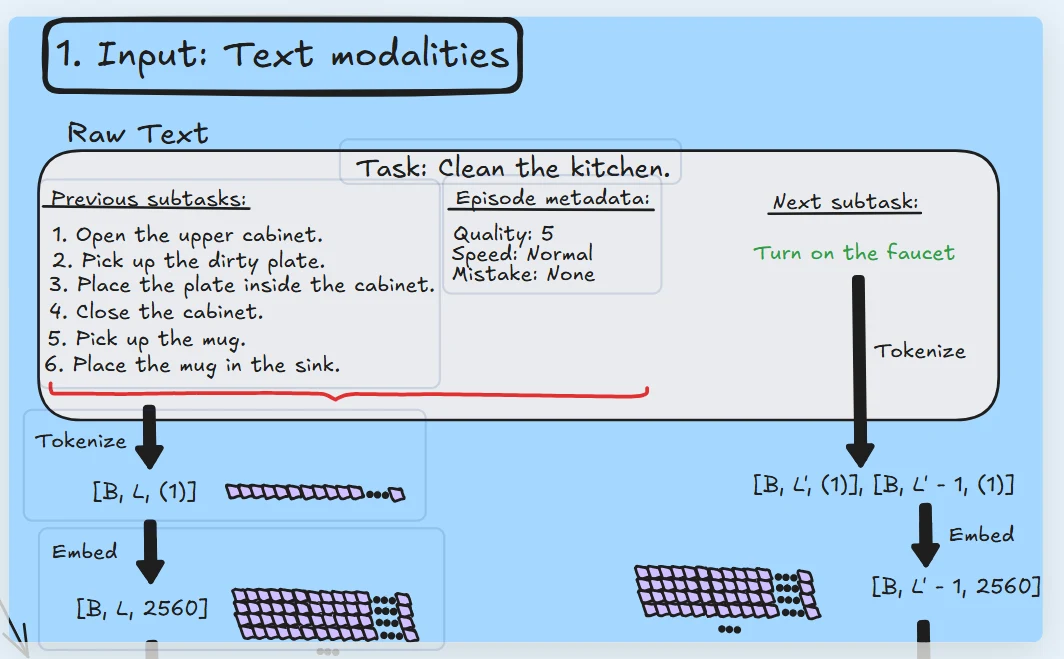
文本输入包含三个部分,第四部分“下一个子任务”是训练目标。
文本输入包括:
- task:“Clean the kitchen.”;
- 按顺序排列的 previous subtasks,例如: “open the upper cabinet, pick up the dirty plate, …, place the mug in the sink”;
- episode metadata:
“Quality 5, Speed Normal, Mistake None”。
Previous subtasks 为 policy 提供任务进度记忆。
如果没有这些历史子任务,那么“柜门关闭”的场景在盘子被收起来之前和之后看起来可能完全相同。
论文将 high-level policy 的输入列为:
- observations;
- task;
- previous subtasks 的历史。
页面架构图还加入了 metadata 这一行。
Task
总体任务,即 low-level model 同样接收的任务文本。
Previous subtasks
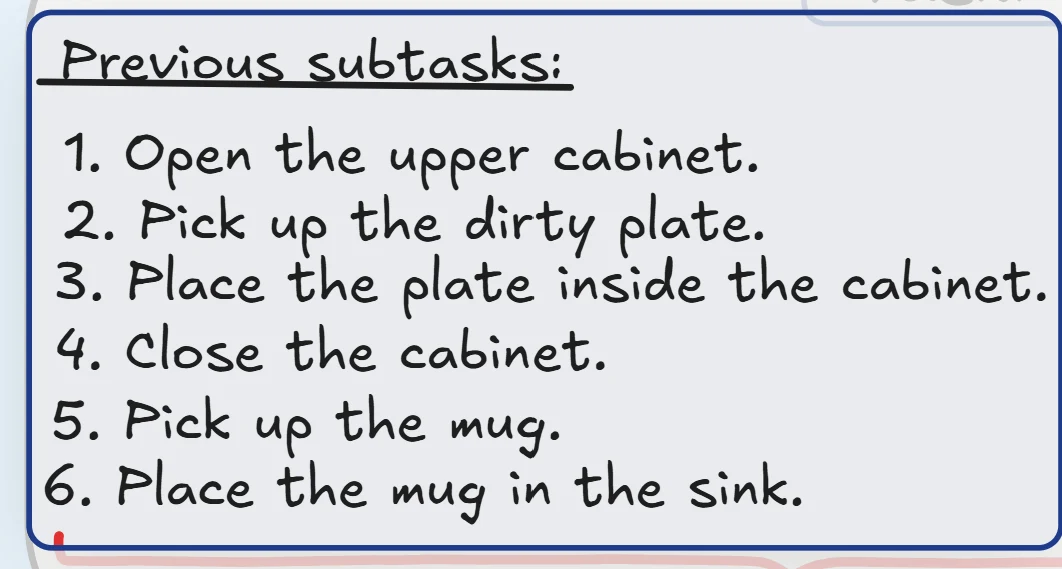
当前 episode 中已经发布的子任务,按照生成顺序编号排列。
每次生成新的子任务后,它都会被追加到列表中,并在下一次预测时作为输入。
Episode metadata
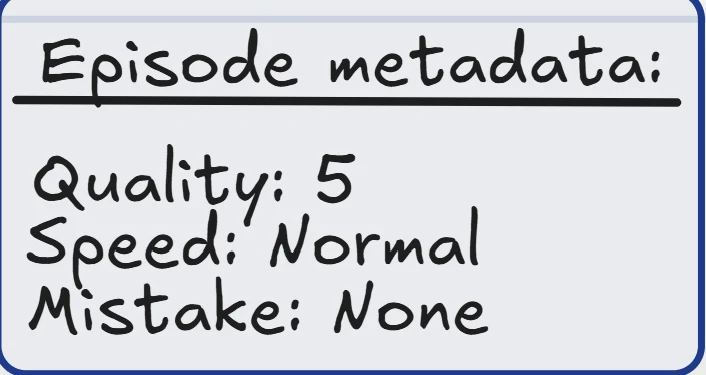
以文本形式写入的 episode metadata,包括:
- Quality;
- Speed;
- Mistake。
格式与 low-level prompt 中的 metadata 相同。
Tokenize
Gemma tokenizer 将文本输入转换为 个整数 ID:
Embed
Gemma embedding table 将每个 ID 转换为 2560 个数字:
Combine image and text context
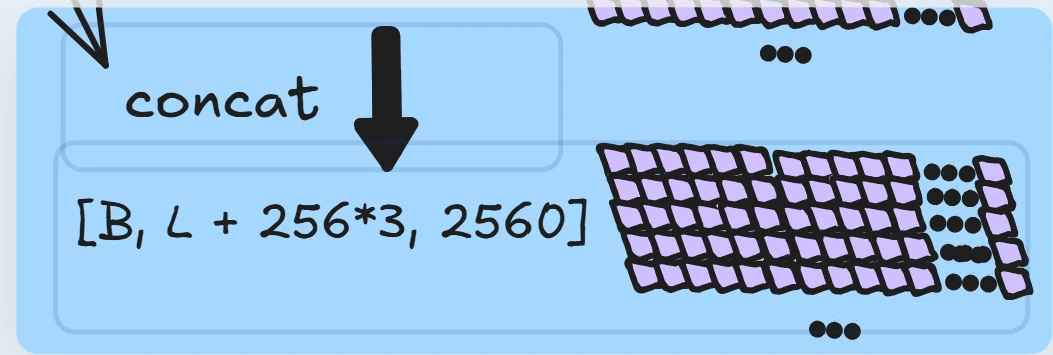
图像 token 和文本 token 沿 sequence axis 拼接,形成 high-level policy 的 context:
该 tensor 在 high-level policy 中扮演的角色,与 low-level model 中的 相同。
Concatenate context
将图像 token 和文本 token 拼接到一起。
[B,L+256 × 3,2560]
其中:
- 是文本 token 数量;
- 是三个相机贡献的视觉 token 数量。
最终 context 的形状为:
Next subtask
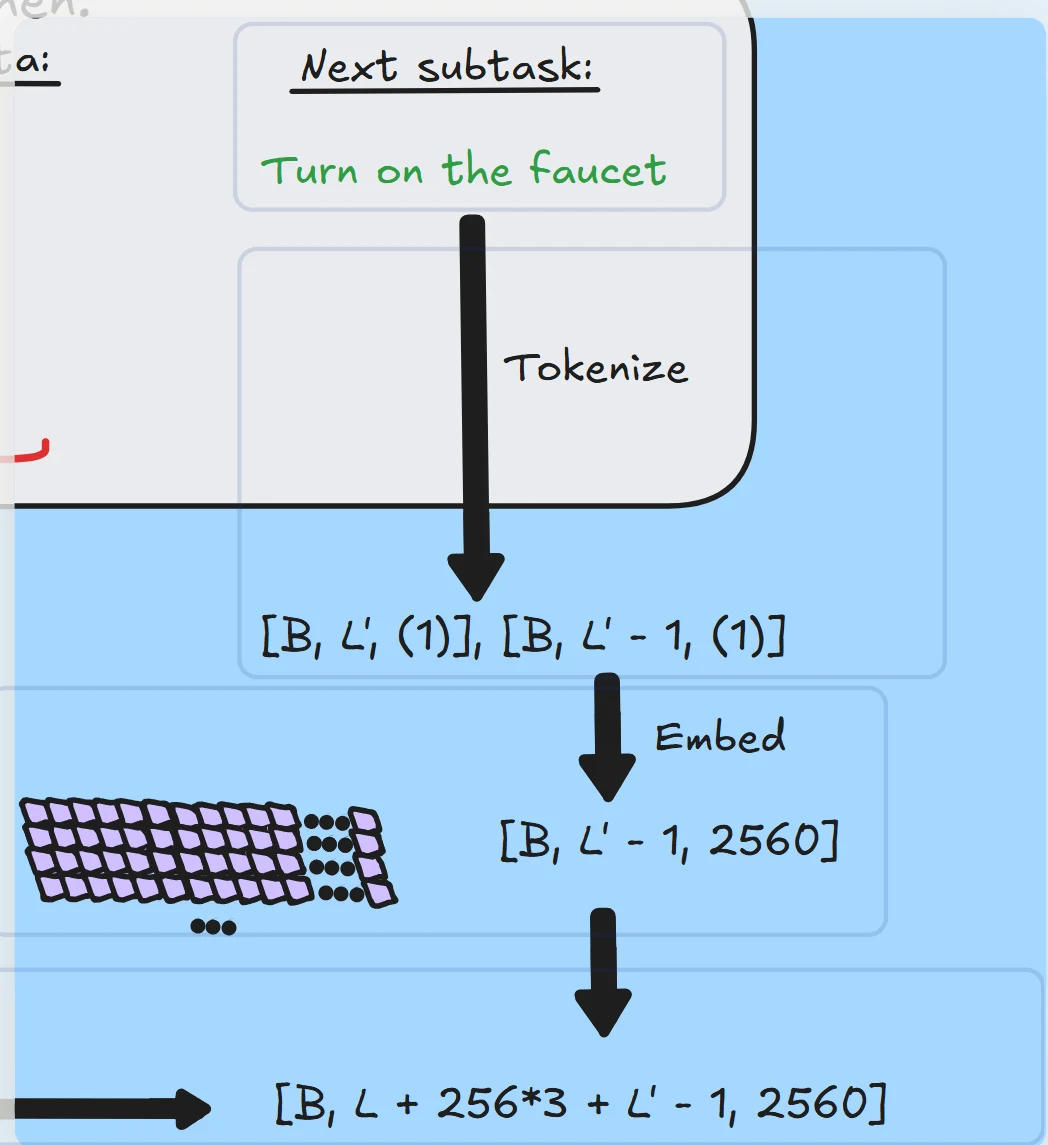
下一个子任务,例如:
“Turn on the faucet”
是训练目标。
它的准备方式与 VLM Loss 中的 FAST token 相同:
- tokenization;
- 为 teacher forcing 进行 shift;
- embedding;
- 追加到 context 后面。
Next subtask text
episode 中标注的下一个步骤,也就是图中用绿色表示的目标文本。
Tokenize target
目标文本被 tokenization 后得到 个 ID:
输入只使用前 个 ID:
与 FAST token 一样,最后一个 token 只会被预测,不会作为输入被读取。
Embed target
前 个输入 ID 使用同一个 embedding table 转换为:
Concatenate target and context
目标 embedding 被追加到 context 后面:
Causal mask 允许每个 target position 读取:
- 完整 context;
- 之前的 target token。
但它不能读取未来的 target token。
Subgoal prediction & loss
整个序列经过 Gemma 的 34 个 Transformer layers。
用于预测 target token 的 个位置包括:
- 最后一个 context position;
- 个 target input positions。
这些位置会被投影到 vocabulary,并与真实的子任务 token 计算 cross-entropy。
具体计算方式与 VLM Loss 完全相同。
运行时,policy 会逐个 token 写出子任务:
- 预测一个 token;
- 将它追加到输入中;
- 再次运行模型;
- 重复这一过程;
- 直到模型预测出文本结束 token。
34 transformer blocks
目标序列经过 Gemma 的 34 个 Transformer blocks。
[B,L’,262208] · logits
模型在 个目标位置输出词表 logits:
Cross-entropy loss
模型将预测结果与真实的下一个子任务文本进行比较,并计算 cross-entropy loss。
World Model:绘制 subgoal images
World Model 为当前子任务绘制 subgoal images:分别针对 front camera、left wrist camera 和 right wrist camera,生成三张图像,描述子任务完成后这些相机应该看到什么。
π0.7 会将这些图像作为 prompt 的一部分读取。
这是一个独立且更大的网络,拥有 140 亿参数,初始化自 ByteDance 的 BAGEL。BAGEL 是一个用于图像理解、编辑和生成的开源模型。
World Model 的输入包括:
- 当前图像;
- 子任务文本;
- episode metadata。
它通过 Flow Matching 生成三张目标图像。
之所以使用独立模型,是为了实现知识迁移。
BAGEL 预训练于 web-scale 图像和视频,World Model 还会进一步使用以下数据进行训练:
- 机器人数据;
- 人类第一人称视频;
- 开源图像编辑数据;
- 视频数据。
因此,它能够想象机器人数据中从未出现过的场景。
Subgoal images 将这些知识传递给 π0.7:
- 有了 subgoal images 后,π0.7 能够更可靠地执行不常见的指令;
- 在论文的“Reverse Fridge to Microwave”任务中,subgoal images 起到了关键作用;
- 对于训练数据中没有折叠任务的机器人,subgoal images 也提高了 zero-shot 毛巾折叠和衬衫折叠的效果。
论文图表中,使用生成式 subgoal 的结果标记为:
“π0.7 (GC)”
页面原文说明:
“Diagram under construction!”
即“架构图正在制作中”。
Inputs and target images
每个训练样本包含:
- 一个子任务指令;
- 当前时刻的 3 张相机图像 ;
- 3 张目标图像 。
目标图像是包含当前时刻 的子任务片段最后一个时间步对应的帧。
episode metadata 也会作为输入。
这些样本来自机器人数据和人类第一人称视频,并且具有较为精确的子任务标注。
论文指出,标注质量会显著影响 subgoal quality,尤其是子任务片段的起点和终点是否被准确标记。
Two encoders:ViT 与 VAE
按照 BAGEL 的设计,每张图像都会经过两次编码。
ViT:负责语义理解
ViT 使用类似 SigLIP 的视觉编码器,patch 大小为 14 像素。
图像被缩放为:
因此每张图像包含:
个 token。
ViT 主要负责表达图像的语义内容,包括:
- 物体是什么;
- 物体位于哪里;
- 场景中发生了什么;
- 当前图像与子任务之间有什么关系。
VAE:负责细节
VAE 是一个图像 autoencoder,用于保留精细的像素级细节。
在其 patching 设置下,每个 token 覆盖 16 个像素。
图像被缩放为:
同样得到:
个 token。
最终需要生成的图像就在这一 VAE latent space 中表示。
训练过程中,模型会接收三份场景信息:
- 当前图像经过 ViT 编码后的表示;
- 当前图像经过 VAE 编码后的表示;
- 在 VAE space 中加入噪声的目标图像。
三个相机视角的每一组 token 都会在两个方向上进行 attention:
- 同一组视角内部彼此读取;
- 目标图像 token 可以根据当前图像和文本条件生成。
Mixture of transformers
BAGEL 是一个 mixture of transformers。
BAGEL 初始化自 Qwen2.5 7B language model。
它包含两个拥有 70 亿参数的 Transformer,并在每一层共享一次 self-attention operation。这种安排与 π0.7 中 VLM backbone 和 Action Expert 的结构类似。
Understanding transformer
Understanding transformer 处理:
- 文本;
- ViT token。
Generation transformer
Generation transformer 处理:
- VAE token。
每个 token 只会经过其中一个 Transformer。因此,总参数量为 140 亿,但对于单个 token 来说,大约只有 70 亿参数处于 active 状态。
Flow-matching loss on images
World Model 使用目标图像上的 Flow Matching 进行训练。
三张目标图像的 VAE token 会与噪声混合。Generation transformer 根据带噪声的 token,预测从噪声状态回到干净目标图像的 velocity。
随后,模型预测的 velocity 与真实 velocity 之间使用 squared error 进行比较。
这与 EAM Loss 的思想相同,只是生成对象从动作 token 换成了图像 token。
生成过程以以下信息为条件:
- 当前图像;
- 子任务;
- episode metadata。
由于每张目标图像都是同一 episode 中更晚时间点的真实帧,World Model 可以从机器人自身相机记录的画面中学习“子任务进展完成后应该是什么样子”。
Inference、refresh 与使用生成目标训练 π0.7
运行时,World Model 与 π0.7 并行运行,而不是位于 π0.7 前面,形成必须等待的串行模块。
When:何时生成
出现以下任一情况时,系统会生成一组新的 subgoal images:
- 当前子任务发生变化;
- 距离上一组 subgoal images 生成完成已经过去 4 秒。
以先发生者为准。
World Model 在独立线程中运行。新的目标图像到达之前,π0.7 会继续使用旧的 subgoal images 执行动作。
How:如何生成
World Model 使用 25 个 denoising steps。
每一步都会同时对文本和图像使用 classifier-free guidance。
带 guidance 和不带 guidance 的两个版本会被打包进同一个序列中,并使用 attention mask 防止它们互相读取。
这样,一次 forward pass 就可以同时计算三张目标图像。
How fast:生成速度
World Model 的序列长度接近 10000 个 token。
在 4 张 H100 GPU 上,使用以下配置:
- 4-way tensor parallelism;
- 8-bit matrix multiplication;
- 修改后的 SageAttention kernel。
生成一组 subgoal images 需要约:
生成图像并不完美,因此 π0.7 也会在训练阶段使用这些生成图像。
除了真实未来帧之外,许多训练样本会使用 World Model 图像替代真实未来图像。这样可以缩小训练阶段与运行时之间的输入差异,因为运行时 π0.7 实际看到的正是 World Model 生成的图像。
Results:π0.7 的实验结果
实验如何进行
每段视频都展示了一个经过训练的模型,独立控制两台模拟 SO-101 机械臂。
整个过程没有使用脚本。每次实验中:
- 方块的位置都会重新随机;
- 收纳箱的位置都会重新随机;
- 目标位置都会重新随机;
- 模型只能看到三个相机;
- 模型只能接收一句任务指令。
例如:
“Hand the blue cube over to the left arm and put it in the bin.”
即:
“把蓝色方块交给左侧机械臂,并将它放入收纳箱。”
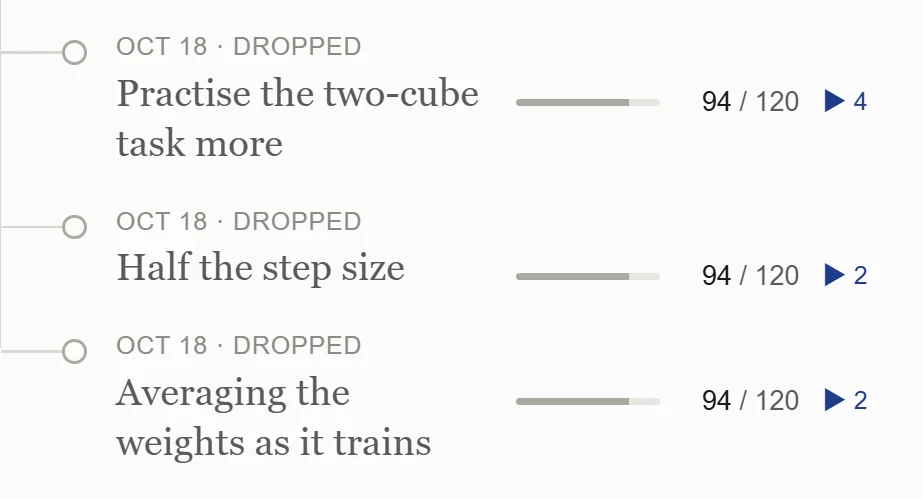
页面按照实验发生的顺序列出所有尝试。每个圆点代表一个实验。点击圆点后,可以查看具体改变了什么,并观看模型运行过程。
图例中:
- kept:保留;
- dropped:放弃;
- running now:正在运行。
评分方式
只有当物体真正被抓起时,实验才算成功。仅仅将物体推到目标位置并不算成功。
对于双臂模型,四个任务分别使用相同的 30 个随机布局进行测试,总计:
次试验。
10 月 17 日之前的分数使用旧版 renderer 测量。同一个模型在旧 renderer 上的得分为 86,而在新版 renderer 上的得分为 90。
主要结果使用 simulator 的普通默认外观。
但训练样本中的以下因素都会随机变化:
- 桌面颜色;
- 方块颜色;
- 光照;
- 相机的小幅位移。
实验树中的“在不同光照和颜色下是否仍然有效?”会打开这些随机因素,测试同一批模型在变化环境中的表现。
实验记录
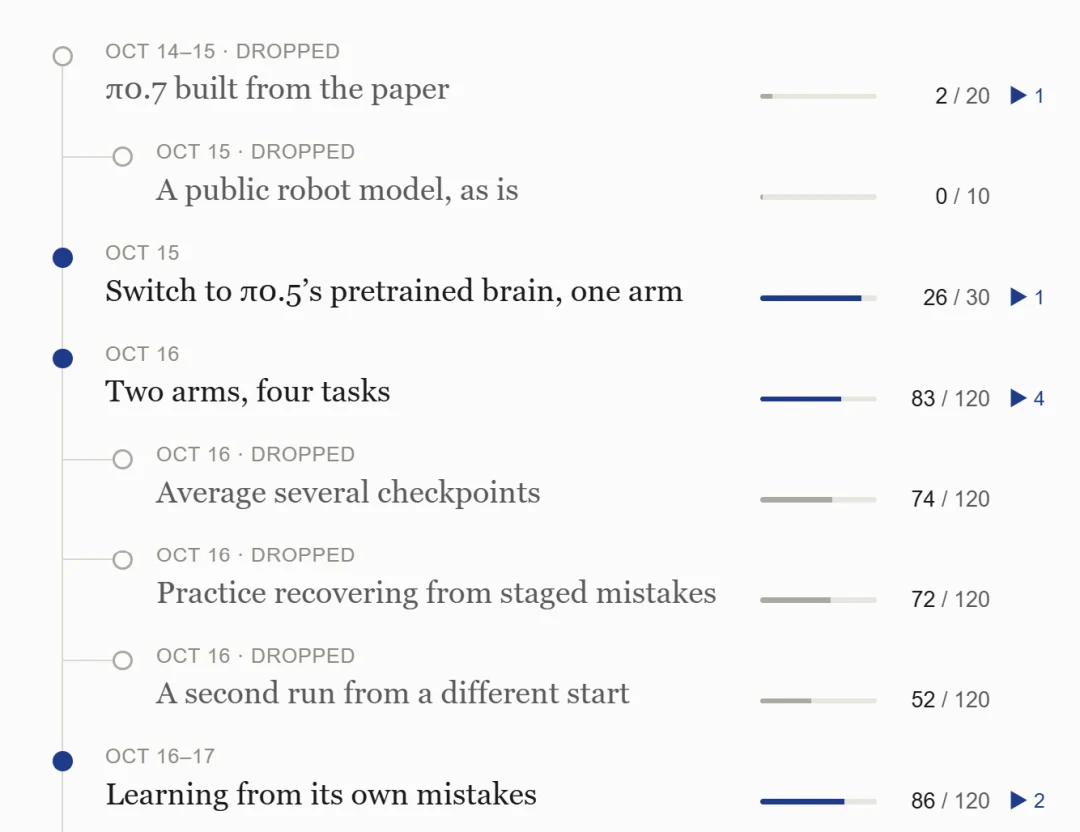
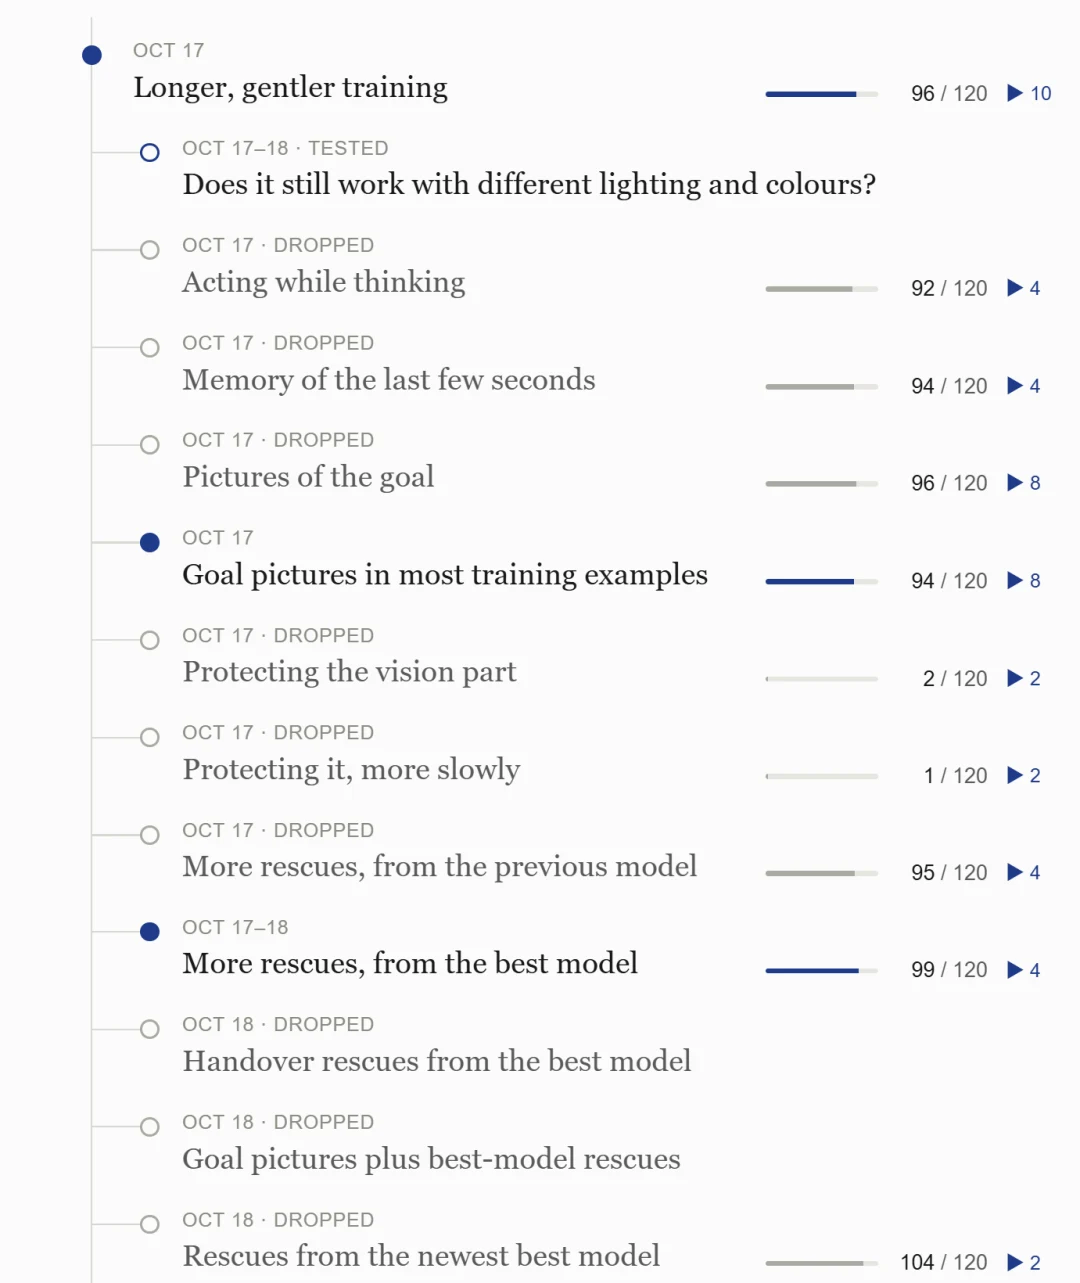
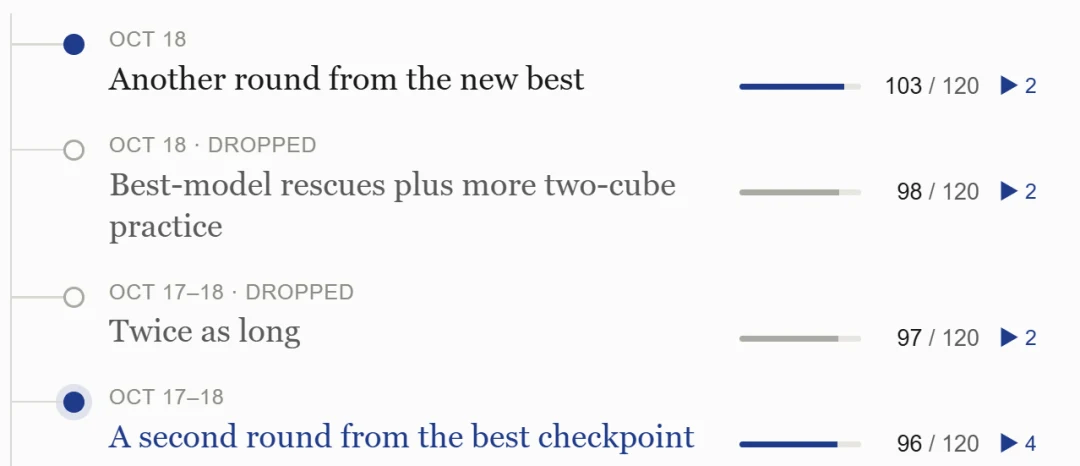
结果
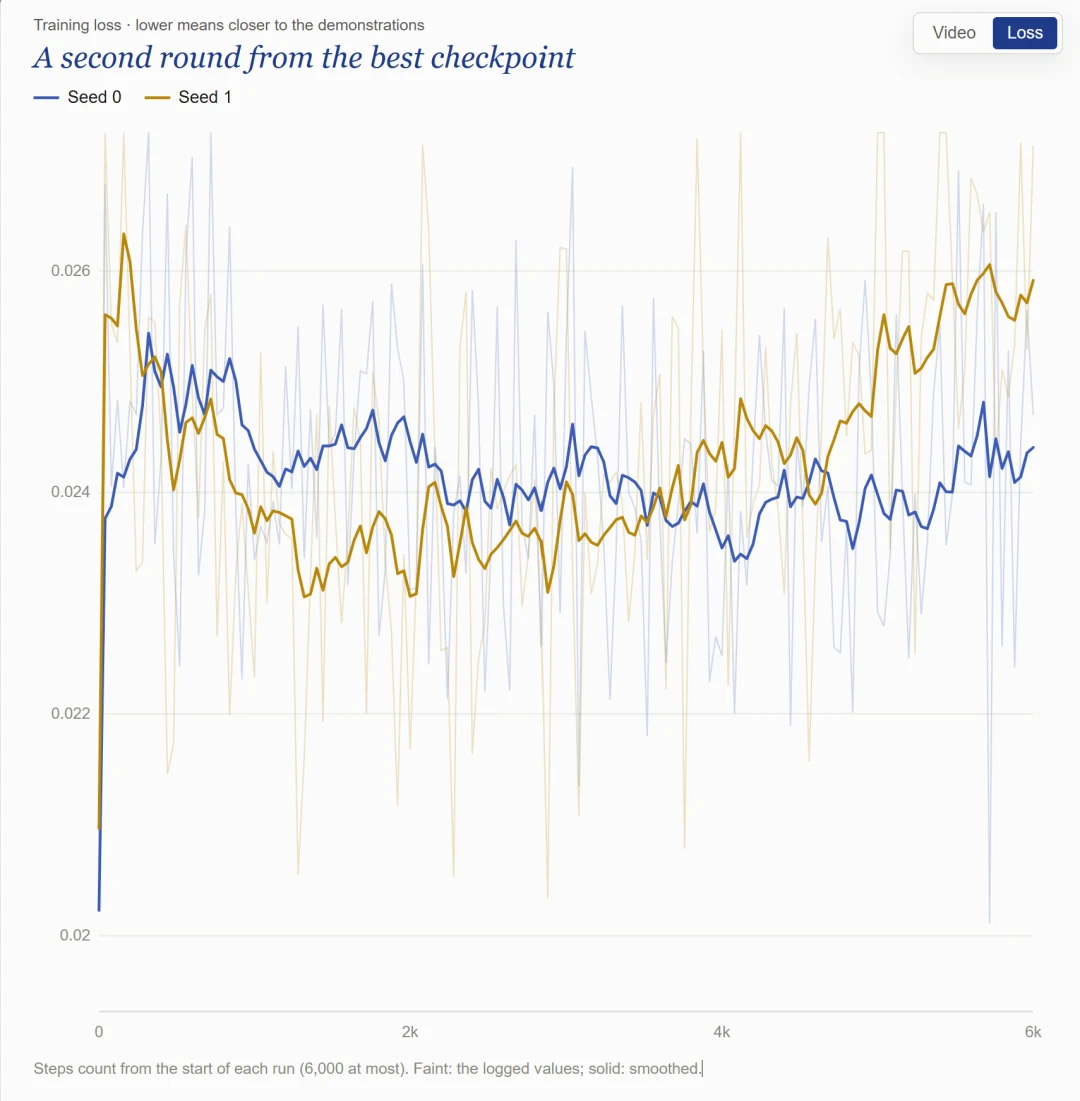
两个训练过程在 8 个 checkpoint 上的平均成绩为:
作为对比,训练开始时的模型得分为:
最佳单个 checkpoint 的成绩达到:
各训练步骤的成功次数
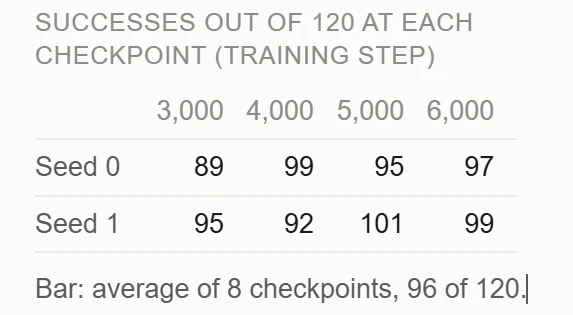
页面中的柱状图显示:
12 个 checkpoint 的平均成绩为:
之后的所有方案,都会与这两次训练结果进行比较。
各任务与 checkpoint
页面列出了以下具体实验视频:
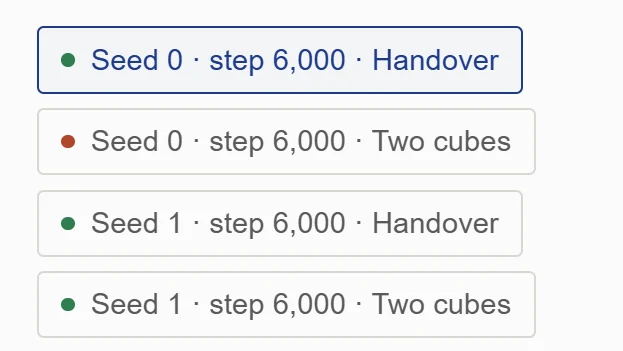
只有当物体确实被抓起时,一次试验才会被计为成功;如果物体只是被推到目标位置,则不算成功。
对于双臂模型,四个任务中的每个任务都使用相同的 30 个随机布局进行测试,共计 120 次试验。
10 月 17 日之前的分数使用较早版本的 renderer 测量;同一个模型在旧 renderer 上的得分为 86,而现在的得分为 90。
主要分数采用 simulator 的普通默认外观。但在训练过程中,每个样本的以下因素都会随机变化:
- 桌面颜色;
- 方块颜色;
- 光照;
- 相机位置的小幅偏移。
实验树中的“在不同光照和颜色下是否仍然有效?”这一项,会在开启上述随机变化后,使用同一批模型进行评分。
搬运说明:本文整理搬运自微信公众号「human five」发表的《两万字学习π0.7 :从多模态输入到实时动作生成》,原图解流程梳理自 acastapaloma.github.io/pi(作者 Kuan Yi Wang & Nathan Y)对 Physical Intelligence
π0.7(arXiv:2604.15483)的推理与训练可视化剖析,仅作个人学习与知识归档之用。