Mac Schwager 现任斯坦福大学航空航天系与计算机科学系副教授,领导多机器人系统实验室(MSL),长期致力于机器人学习、多机器人协同与分布式控制领域研究。他聚焦具身智能与通用机器人策略的核心问题,针对当前主流 VLA 模型,系统开展泛化能力、记忆化机制与数据缩放规律的科学验证,揭示了现有通用机器人策略在实际部署中的脆弱性与局限性。
引言:VLA 真的具备通用泛化能力吗?
我接下来要讲的是被大家称作 VLA 的策略,也就是视觉-语言-动作策略。这类策略在创业圈和研究领域都引发了极高关注,而且它们确实能实现一些惊人的效果。我先放一段视频,来自行业头部公司 Physical Intelligence(PI)。
Pi0 展示了一台双手操作机器人,它看起来做工很粗糙,就是临时拼凑起来的设备,不是 Panda 这类高精度机器人。但这台机器人能处理一整筐衣物,把各种衣物逐一折叠好,码放得整整齐齐。
如果你从事机器人操控研究,这个效果绝对会让你印象深刻。无论他们是如何实现的,这一成果都相当震撼。这些策略也因此被冠以通用策略、具身 AI 的名号,甚至被认为是将大语言模型、视觉语言模型中的 AI 涌现能力迁移到物理世界的桥梁。
因此,业界对这类模型的能力抱有极高期待,但同时也充斥着大量炒作,人们对它们的真实能力、宣传效果与视频演示效果之间的区别知之甚少。这场报告的核心,就是我团队近期发表的多篇预印本论文(即将正式投稿)——我们用标准技术范式,科学地探究了这类策略的能力边界。
这场报告的主题是泛化能力:通用机器人策略到底能否泛化?核心结论是:在当前标准实践下,它们无法泛化。这些模型实际上非常脆弱,且存在大量记忆化行为。但我希望这场报告是面向未来、积极乐观的。对学术界研究者来说,这是个好消息——问题还没被解决,AI 还没让我们失业。目前具身 AI 的实际效果并不理想,但仍有希望的曙光,也有大量值得探索的研究方向,能让我们离真正的通用机器人策略更近一步。
1. 从 RT-2 到 π0:VLA 的演进与模仿学习范式
接下来,我会简单拆解 VLA 的架构,并梳理它的发展历程。这个概念距今已有近 3 年历史,在 AI 的迭代速度里,至少相当于 30 年。
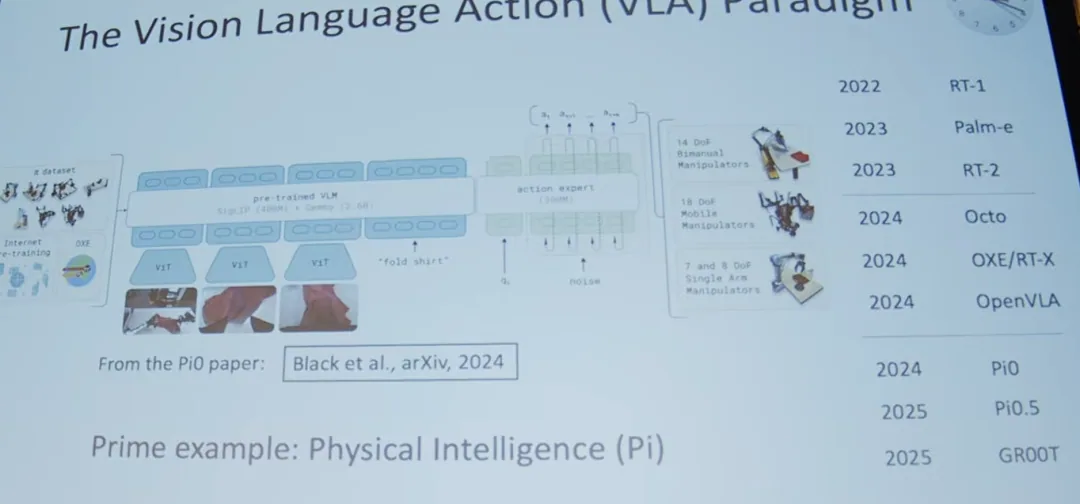
2022 到 2023 年,Google DeepMind 旗下 Google Robotics 的一批研究者,将谷歌内部的语言模型用于机器人控制,并发表了相关论文,效果看起来十分惊艳,但模型权重并未开源,外界无从得知其实现细节。即便如此,这仍在研究界掀起了热潮。
到了 2024 年,这批原论文的作者陆续开源了模型,包括 Octo、OpenVLA,还有 OXE(Open Cross Embodiment)——一个大规模数据集项目,现场很多实验室都参与了这个数据集的构建。该论文还基于 RT-2(也可能是 RT-1)的架构,用这个数据集训练了模型。
这些模型向研究界开放后,大家开始实际测试,却发现根本不好用。随着时间推移,参与这些研究的原作者们创立了 PI 公司,核心成员包括伯克利的 Sergey Levine、斯坦福的 Chelsea Finn,以及一批原 Google Robotics 的研究员。
PI 随后发布了首个开源模型 PI-0(就是我刚才放的视频里用的模型),之后又推出了 PI-0.5。据我所知,这是目前学术界可测试的最新、最先进的 VLA 模型。其他大型 AI 公司也纷纷入局:英伟达负责人形机器人研究的 GEAR 团队,在 2025 年推出了 Groot 模型;还有 Gemini Robotics,但并未开源,学术界无法测试使用。
所以我们目前能用到的主要就是 PI、PI-0.5 和 Groot。这些模型确实能实现一定效果,能输出合理的运动指令,只是我还没见过能折叠我家衣物的机器人。它们能完成一些有趣的任务。
归根结底,这些模型的结构非常简单:一个完全未针对机器人任务训练的预训练 VLM。主流选择是 PaLM-E、Gemma 这类开源模型,参数规模约 30 亿,对比 Gemini 的万亿级参数,仅为其千分之一。
之后会在模型上拼接 Transformer 模块,称作 Action Expert;再通过模仿学习,用机器人数据对整个架构进行后续预训练。具体来说,就是采集机器人遥操作的示范数据,用这些数据训练模型,之后再在实验室或工业场景中通过 SFT 适配特定任务。这就是当前的主流范式。
这一理念吸引了巨额资本投入,催生了一大批高估值初创企业。我最熟悉的 Physical Intelligence 估值达 56 亿美元,融资超 10 亿美元;Skild 估值更是达到 140 亿美元。大量资金涌入这个领域。
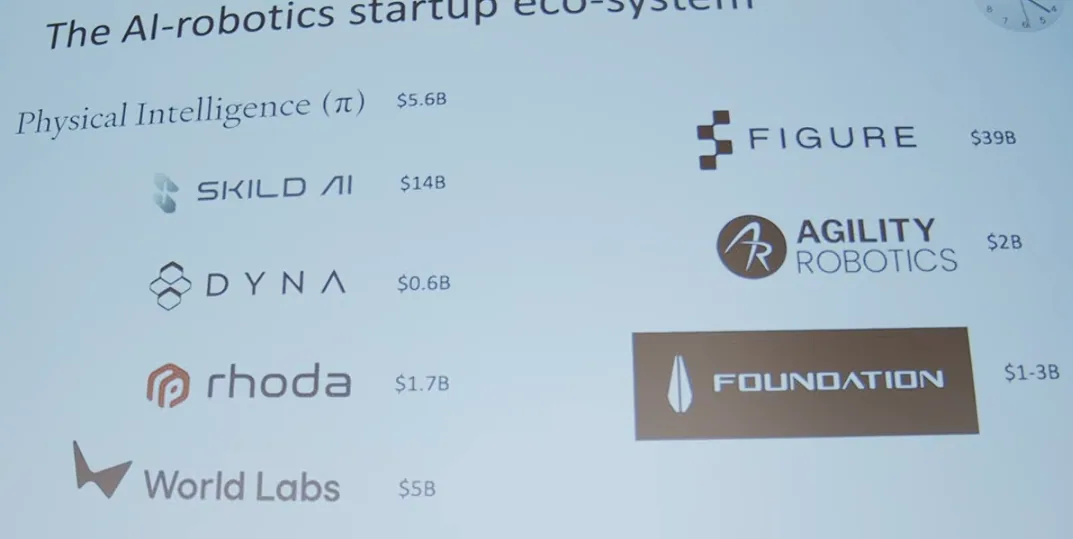
当然,这些初创企业会发布极具吸引力的演示视频,展示惊人效果,却不公开可复现的技术细节。作为科研人员,我们都清楚这是很危险的。因此,我的团队着手研究几个核心问题:
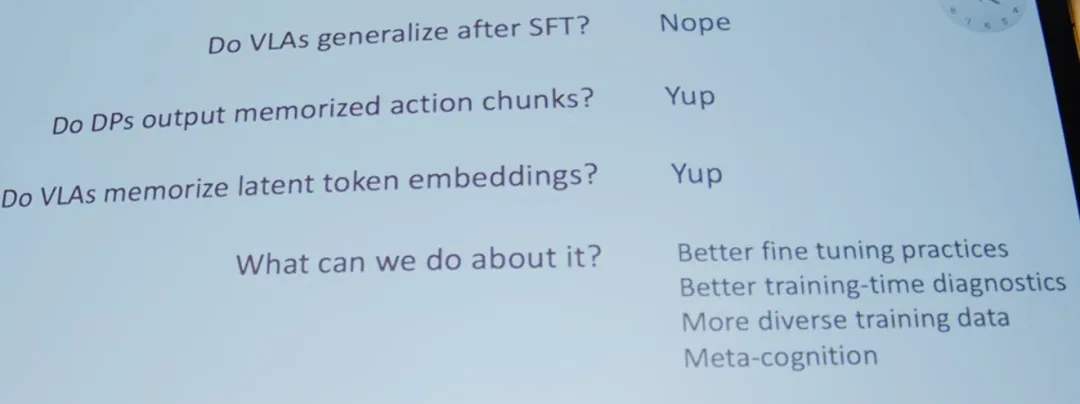
- VLA 在 SFT 后能否泛化? 这是关键。这些模型在海量数据上经过多阶段预训练,学习了互联网级数据,但开箱即用效果很差——因为它们适配的是 PI 的实验环境,而非你的实验室环境,必须经过 SFT。而我们的发现是:SFT 后的 VLA 几乎完全无法泛化。
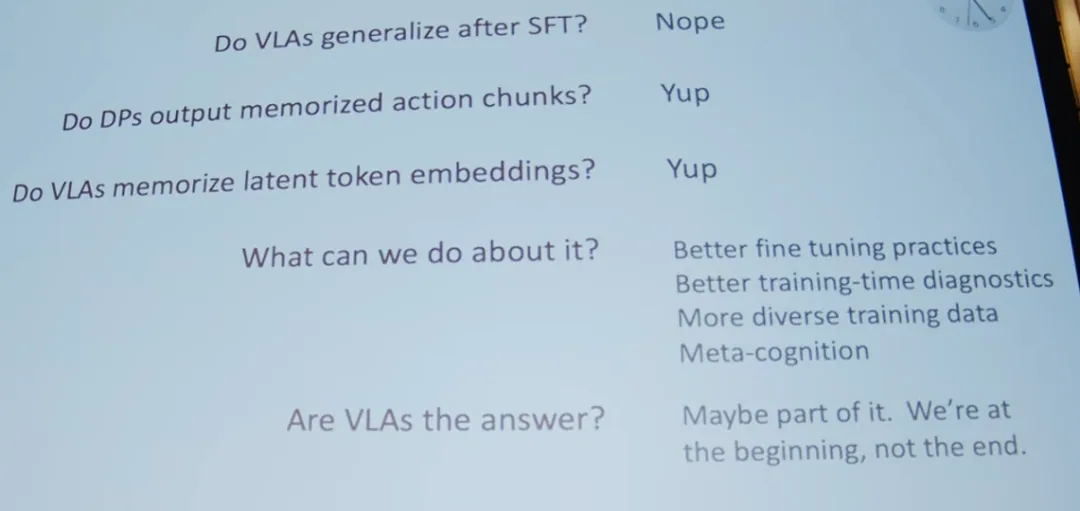
这当然和 SFT 的数据量、训练方法相关,但就目前来看,模型极其脆弱。
- 第二个问题:VLM 上拼接的这个模块,源于 2023 年的一个早期思路——Diffusion Policy,这是一个单任务策略,而非通用策略。我们深入研究了 Diffusion Policy,探究它在动作输出空间的泛化能力。
结论是:完全没有泛化能力,几乎 100% 记忆训练动作片段。所谓动作片段,就是短序列动作。换句话说,模型在推理时输出的动作序列,几乎是训练集中某段动作的完全复刻。它只是记住了动作片段,相当于一个查表系统。
- VLA 是否会记忆隐层 Token 嵌入? 不仅是 Action Expert,上游 VLM 主干的语言 Token 中,是否也存在记忆化?答案是肯定的。我们基于稀疏自编码器开发了一套工具,用来分析主干网络中 Token 嵌入的稀疏基,结果发现绝大多数 Token 嵌入都来自训练数据的记忆。
但我不想让这场报告变得悲观,而是希望聚焦未来。我们还有大量工作要做,也有很多有意思的研究方向。那么该如何解决这些问题?
接下来我会介绍几种简单的 SFT 优化方法,能缓解 SFT 后泛化能力缺失的问题;然后讲我们改造的稀疏自编码器工具,用于 VLA 诊断,能在部署前提前评估模型的泛化能力。我们所有研究都指向一个共同结论:更大规模、更多样化的 SFT 数据集,能带来更好的泛化行为——即便这种泛化依然很脆弱,但趋势明确:数据规模扩大,策略泛化能力会提升。
从理论层面看,模仿学习的训练范式本身存在固有局限。如果我们想要机器人能自主学习、拆解问题、思考解决方案、探索新方法,就必须引入元认知能力。元认知就是对思考本身的思考,感知自身的局限、能力与执行效果。而当前这些模型完全不具备元认知,它们只是反馈式策略,没有记忆,输入图像就输出动作,无法判断输出的好坏。
那么,VLA 是最终答案吗?通用机器人的问题已经解决了吗?当然不是,但它可能是答案的一部分。这是一个有趣且有价值的研究方向,前路漫漫,这只是开始,而非结束。
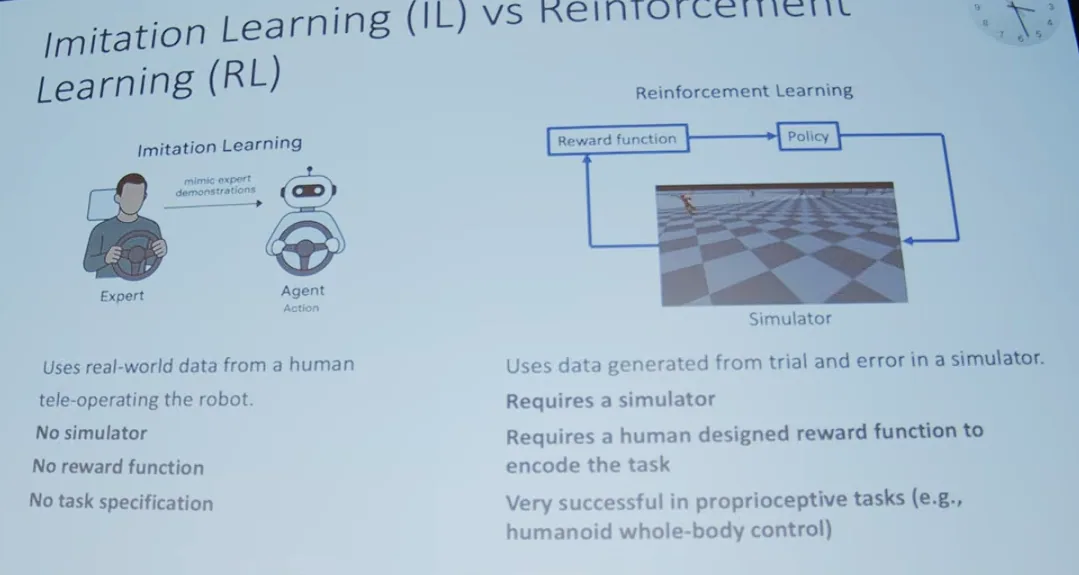
简单讲一下模仿学习。模仿学习是传统的机器人学习方法,优势在于简单:无需仿真器、无需人工定义奖励函数、无需人工定义任务。只需要人类专家操控机器人,同步采集多摄像头图像与专家通过遥操作发出的动作,构成训练数据集,再通过监督学习训练策略,学习图像到动作的映射。任务本身隐含在数据中,人类试图完成的行为,机器人通过复刻动作来复现。
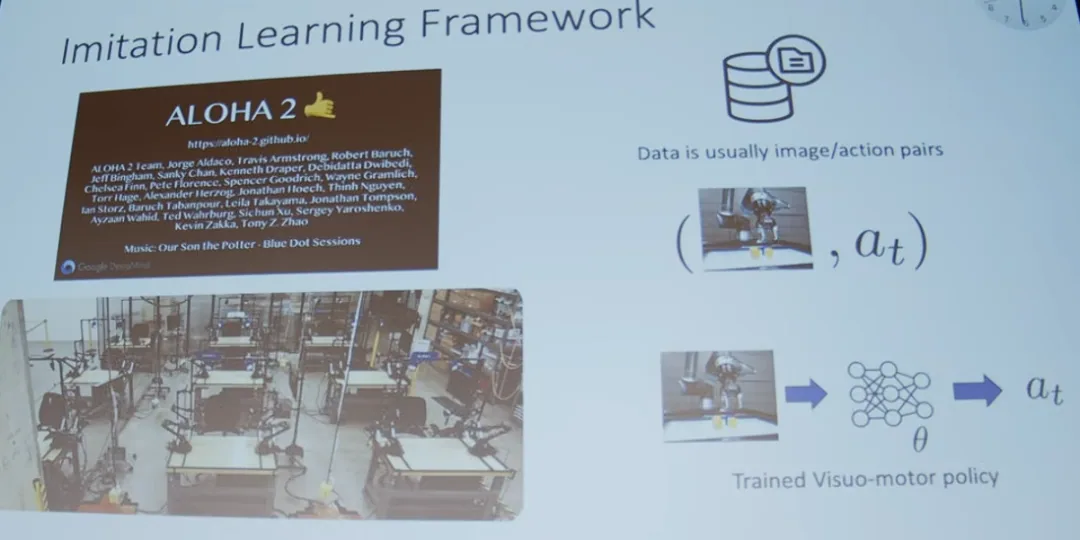
这与过去 15 到 20 年主导机器人学习的 RL 形成鲜明对比。RL 的理念很振奋人心:无需人类参与,算法自主探索策略空间,通过迭代实现自我优化。但 RL 的缺点也很明显:需要仿真器,策略容易过拟合仿真环境,无法迁移到现实世界;需要人工设计奖励函数,界定好坏行为,而奖励函数的设计极其困难。相信实验室里做 RL 的博士生都深有体会,RL 研究很多时候都在反复调参优化奖励函数,过程十分痛苦。
尽管如此,RL 在近期仍取得了一些成功,主要集中在人形机器人全身控制领域——这类场景有完善的仿真器,无需视觉输入与语言理解,纯本体感知任务,更接近传统反馈控制,策略能充分发挥优势。
比如 Unitree 机器人做出蝴蝶踢、踢飞空中西瓜的演示,用的就是 RL 策略,完全没有视觉理解能力,也不使用语言,只能稳定重复执行单一动作。
说回模仿学习。放在 3 年前,如果有人说“模仿学习会颠覆机器人操控领域”,大家都会觉得不可思议。但如今,模仿学习确实成为了推动技术发展的核心。与之配套的,是一套标准化的双手遥操作作业单元。
这是标准的双手操控遥操作作业单元:两个主动机械臂,两个被动机械臂由操作员控制,主动臂像木偶一样跟随运动,操作员通过扳机控制夹爪。熟练的操作员能用这套设备完成精细、灵活的操控,但需要大量技巧。
如今在硅谷和中国深圳,一种新商业模式正在崛起:数据采集仓库。大型仓库里摆满这类作业单元,雇佣工人 24 小时轮班,8 小时工作制,像传统工厂工人一样完成任务清单——折叠 18 件 T 恤、收纳 3 个盘子等等,完成后打卡下班。数千名工人从事这份工作,本质是被采集人类操作数据。这就是这些企业扩大数据规模、追求所谓“机器人领域 ChatGPT 时刻”的核心模式。
更具体地说,采集的数据包括:单时间步多视角图像(腕部视角 + 至少一个第三人称视角),以及动作片段——当前动作 + 未来 16 步动作,对应约 2 秒的 rollout。这就是一组数据对,输入神经网络后就得到策略。这是纯粹的反馈策略:图像输入 → 动作输出,无记忆。这其实是刻意设计的,有研究者尝试加入历史图像作为条件输入,反而导致性能下降,具体原因尚不清楚,但这已是行业共识。
再讲讲这类模型的前身。2023 年,也就是我所说的“黑暗时代”,RSS 会议上有两篇突破性论文:一篇来自 Chelsea Finn 团队,提出 ACT(Action Chunking Transformer);另一篇来自 Shuran Song 实验室,与 TRI 的 Rusty Drake 团队合作,提出 Diffusion Policy。
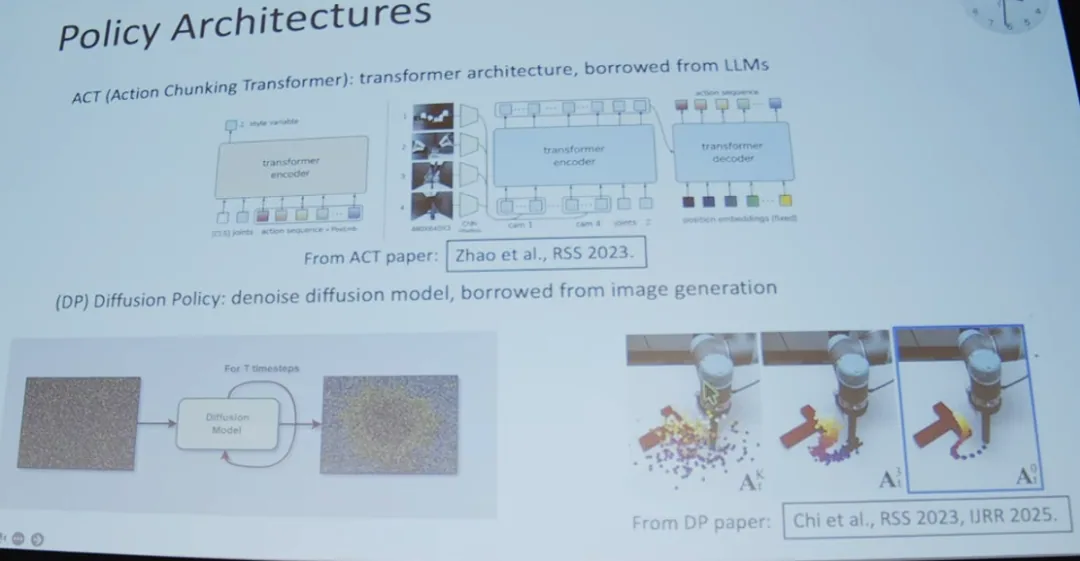
- ACT 的创新点:用轻量化 Transformer(非 LLM 的大 Transformer)建模策略。
- Diffusion Policy 的创新点:将当时生成式 AI 的 SOTA 扩散去噪模型,改造用于动作片段去噪——从随机动作开始,训练去噪器,逐步迭代生成连贯的动作规划。
这两篇都是突破性工作,发表不到 3 年,引用量均超 1400 次。我们实验室也验证过,它们效果出色,但都不是通用策略,而是单任务策略。专门训练完成单一重复任务,在特定数据分布内表现稳定、鲁棒性强。
之后的架构迭代,就是把 Transformer 和去噪 Action Expert 结合,形成 VLA 架构:主干是 Google 团队预训练的大语言模型 Transformer(Gemma 团队,专职训练开源模型,和机器人无关),先用于视觉问答任务,开源后被 PI 等公司采用,拼接 Action Expert,再进一步训练。
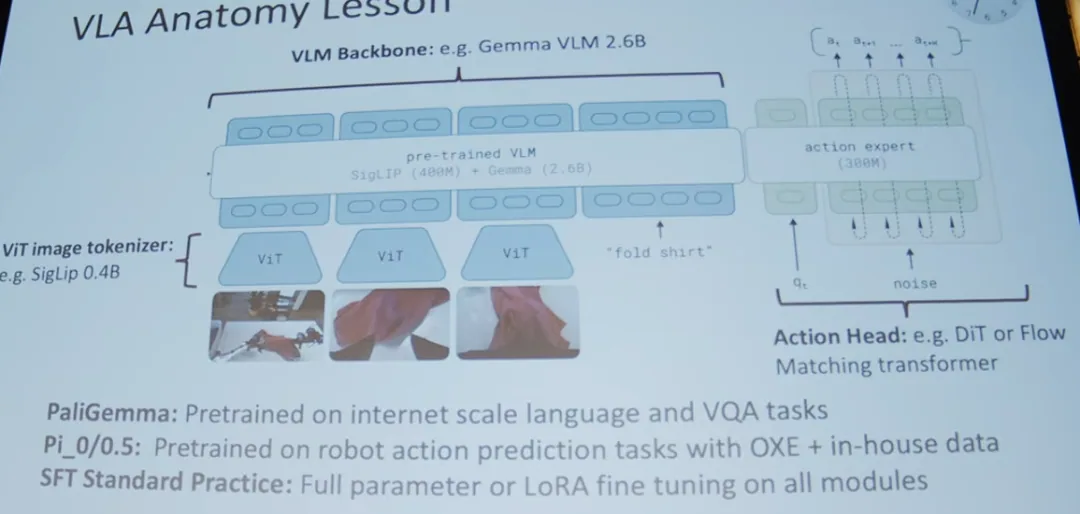
主干分为两部分:
- 视觉编码器:相当于图像 Tokenizer,将图像分块转为 Token,与语言 Token 处于同一空间,让主干能用同一套词汇表征图像和语言;
- 主干先在文本语料上预训练(和多数 LLM 一致);
- 再通过模仿学习,联合训练整个架构,让模型输出动作 Token。
整个过程包含多阶段预训练:ViT 与 LLM 各自预训练 → 两者联合预训练 → PI 进一步预训练 → 最终用户通过 SFT 适配特定任务与环境。
2. SFT 后的过拟合陷阱:概念锁定与空间锁定
回到 SFT 后模型测试的问题。近期有多项相关研究,包括我们团队的工作,以及另外两项工作,都指出了 SFT 后的过拟合问题,我们称之为锁定效应。简单说:经过 SFT 后,所谓的通用模型完全丧失泛化能力。
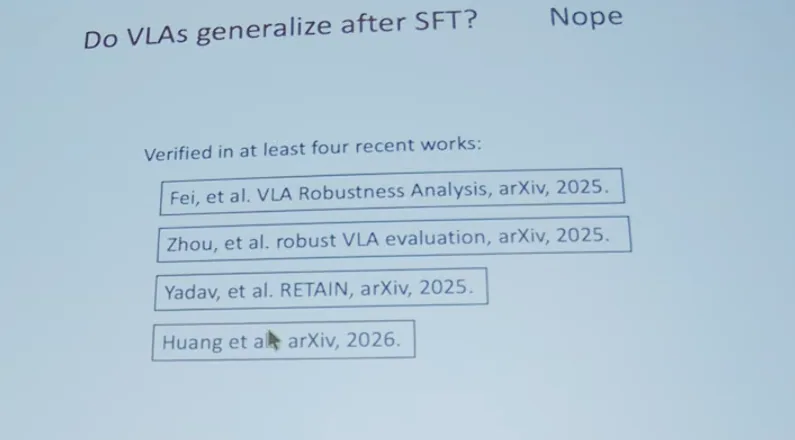
这一点在多篇论文中都有验证,甚至包括 Sergey Levine 团队的论文——这一点很可贵,因为 Sergey Levine 是 VLA 理念的核心推动者。我并非贬低他,他的研究极具远见与价值,但他能坦诚发表论文指出模型存在过拟合,这一点值得肯定。
而我们团队的工作,则提出了 SFT 方法改进,缓解过拟合问题。
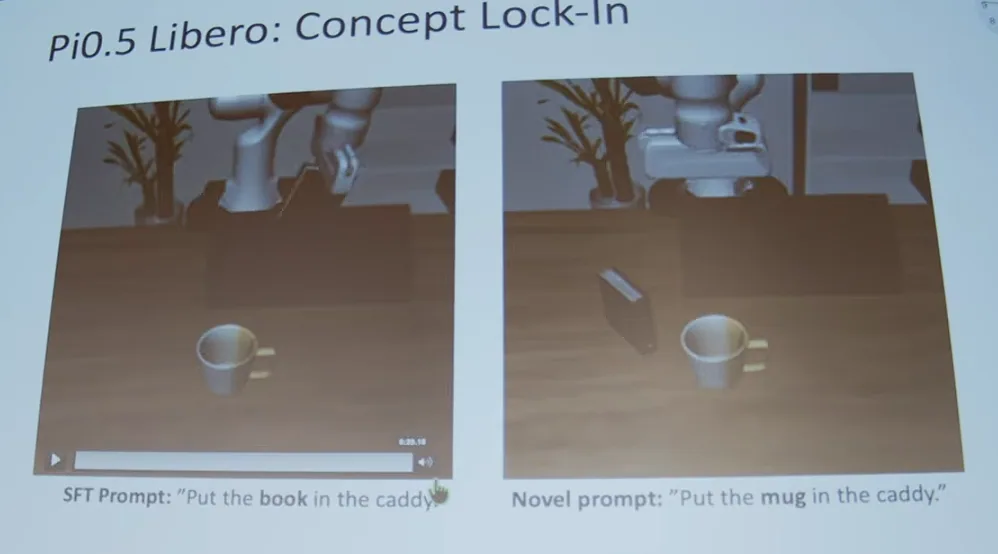
举个例子:PI-0.5 在 Libero 数据集上预训练 + SFT。Libero 是操控领域常用的仿真基准数据集,规模很小,只有 50-100 条示范数据,这也是绝大多数研究者的小数据 SFT 场景。
其中一个 SFT 提示是:把书放进收纳盒。模型完成得还可以,只是书有点歪,勉强算成功。
再让它执行:把杯子放进收纳盒。模型却无法抓起杯子,动作卡在书和杯子之间,杯子倾倒,反复去够杯子顶部。
要知道,在其他场景中,这个模型完全能识别杯子、顺利抓取。问题在于:SFT 过程中,模型错误地将场景背景与任务绑定,看到收纳盒就默认任务是放书,收到“放杯子”的提示时就会陷入混乱。这是我拟人化的解释,但本质就是这个现象。
我们把这种现象称作概念锁定:任务概念与场景外观错误绑定,导致模型无视指令。
还有一种现象叫空间锁定:SFT 提示是把白色杯子放到右侧盘子、把黄色杯子放到左侧盘子,模型在验证集(与训练集相似但不完全相同)上能完成。但更换提示:把白色杯子放到左侧盘子、把黄色杯子放到右侧盘子,模型完全无视位置要求。
这说明模型产生了空间偏置:白色杯子默认向右、黄色杯子默认向左。即便模型在其他任务中能灵活放置杯子,在这个场景下依然被锁定。
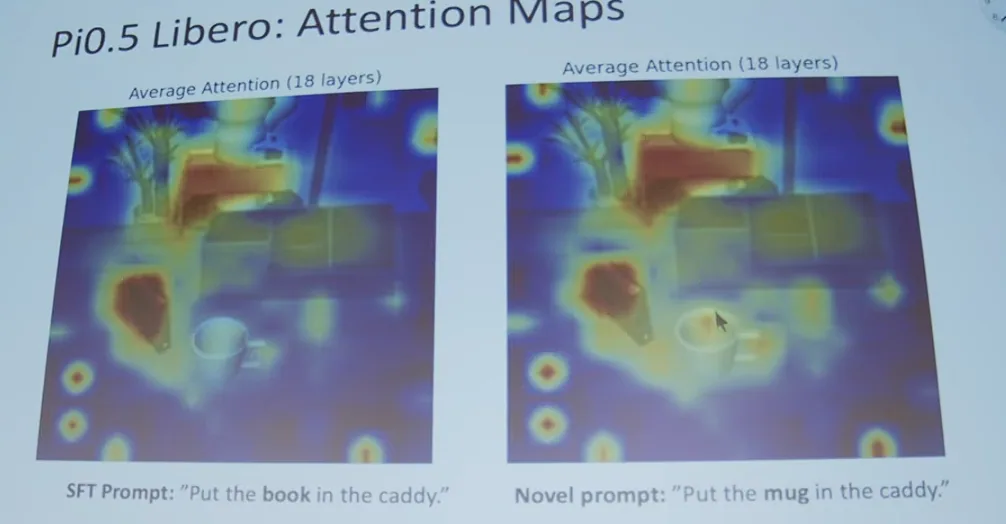
我们用现有工具做了机理解释:观察注意力图,提示“放书”时模型关注书,正常;提示“放杯子”时,模型依然主要关注书,对杯子的注意力不足,无法完成任务。
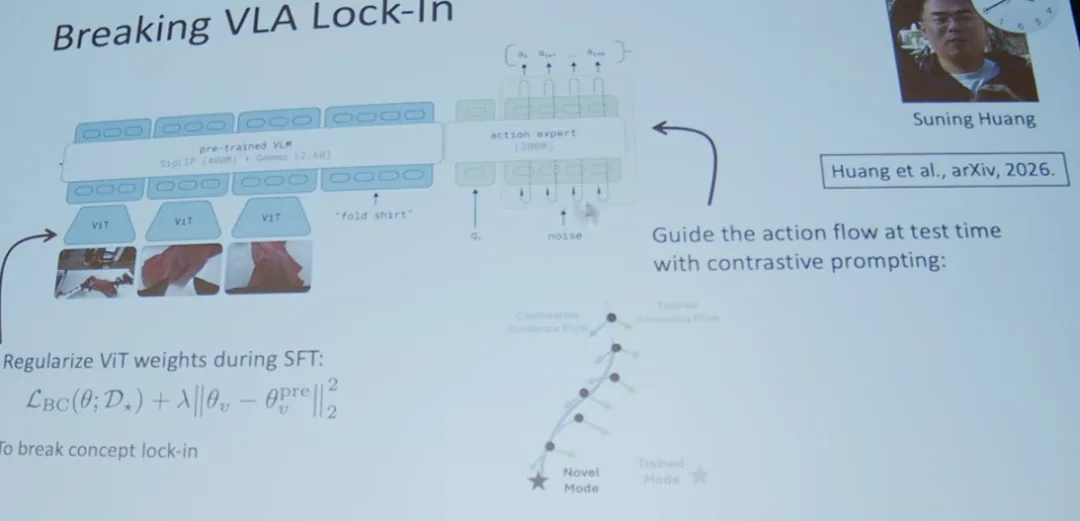
我的学生 Suning(由我和 Jeannette Bohg 共同指导)发现了这个问题,反复实验后确认,这是 VLA 在 SFT 后的共性问题。他尝试调整 SFT 方法:传统 SFT 会更新所有模块权重,或用低秩适配(仍修改权重);他则将模型分为视觉编码器、语言主干、Action Expert 三个模块,尝试不同的冻结、解冻与正则化组合。
最终找到两个简单有效的解决方案:
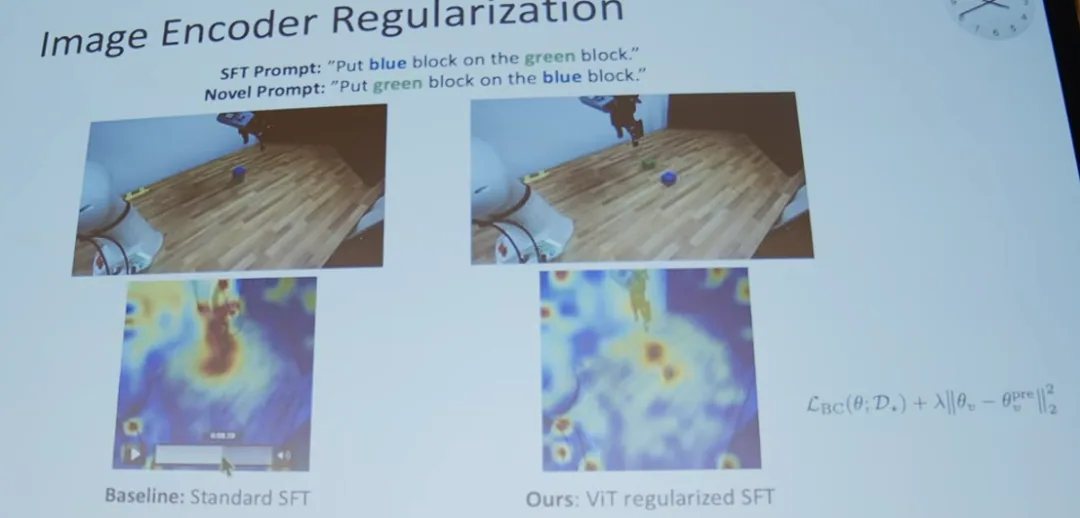
- 对 ViT 权重施加传统 L2 正则化,防止其偏离预训练权重,能大幅打破概念锁定,保留视觉-语言的关联能力,提升未见提示的泛化性;
- 用对比提示引导缓解空间锁定:同时输入目标提示与反向提示,对 Action Expert 输出的矢量场做线性组合(正向提示加权、反向提示负加权),明确约束模型“做什么、不做什么”,打破物体与方向的绑定。
给大家看实际效果:
- 标准 SFT:指令“把绿色方块放到蓝色方块上”,模型无视指令,执行 SFT 中见过的动作,注意力全在蓝色方块,而非绿色方块;
- 仅对 ViT 施加 L2 正则化:无新增数据、无额外训练,仅添加正则项,模型顺利完成任务,注意力聚焦正确目标。
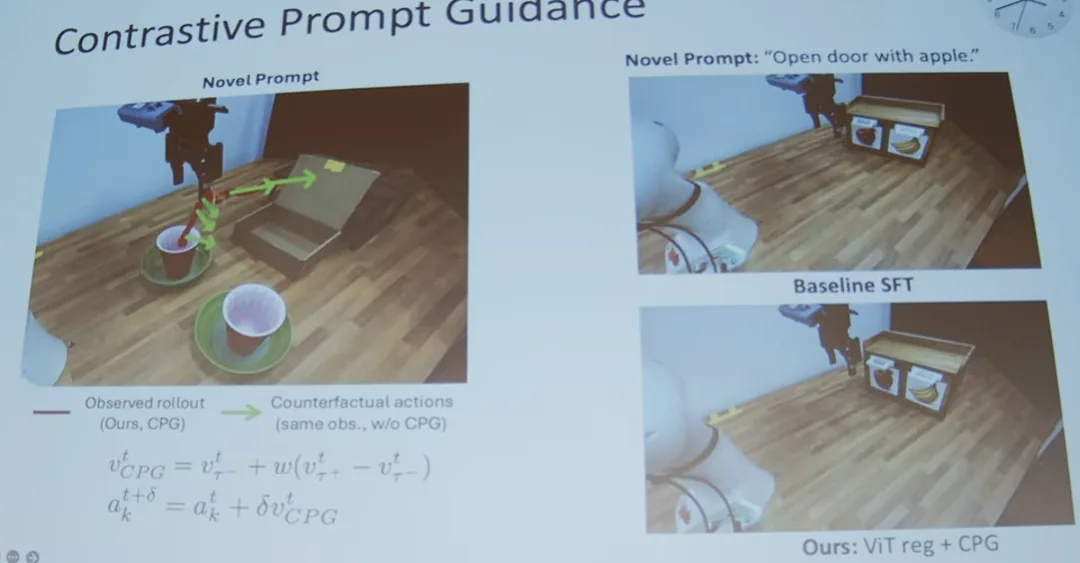
再看空间锁定的缓解:模型经 SFT 学习“把右侧杯子放进盒子”,指令改为“把左侧杯子放进盒子”。无对比引导时,矢量场指向右侧杯子,轨迹错误;加入对比引导后,轨迹纠正为左侧杯子。
还有组合效果:指令“用苹果开门”。标准 SFT 因训练数据是“用香蕉开门”且固定向右,出现概念 + 空间双重锁定;加入 ViT 正则化 + 对比提示引导后,模型顺利打开正确的门。
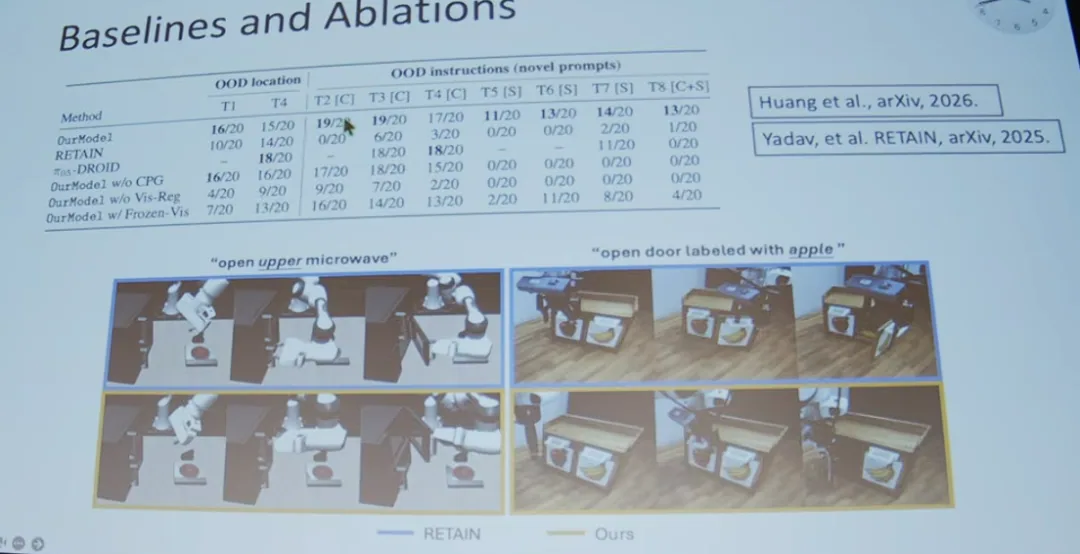
当然我展示的是成功案例,需要用数据支撑。我们的方法在两类问题上的成功率:
- 概念锁定(C):20 次成功 19 次;
- 空间锁定(S):20 次成功 19 次;
- 概念 + 空间复合问题:20 次成功 13 次。
这是 VLA 的典型成功率:通常不超过 70%-75%,简单抓取放置任务可达 90%。
作为对比:
- Sergey Levine 团队的方法:权重空间平均,略有提升,但效果有限;
- Droid 数据集(更大规模)SFT:数据多样性与规模提升,表现更好,说明部分问题可通过大数据缓解;
- 移除我们提出的模块:性能下降;
- 标准 SFT:所有场景成功率为 0。
3. Diffusion Policy 实证:动作片段的“查表式记忆”
接下来深入分析输出头——基于 Diffusion Policy 的模块,探究它如何推理动作片段,是否真的在记忆输出。
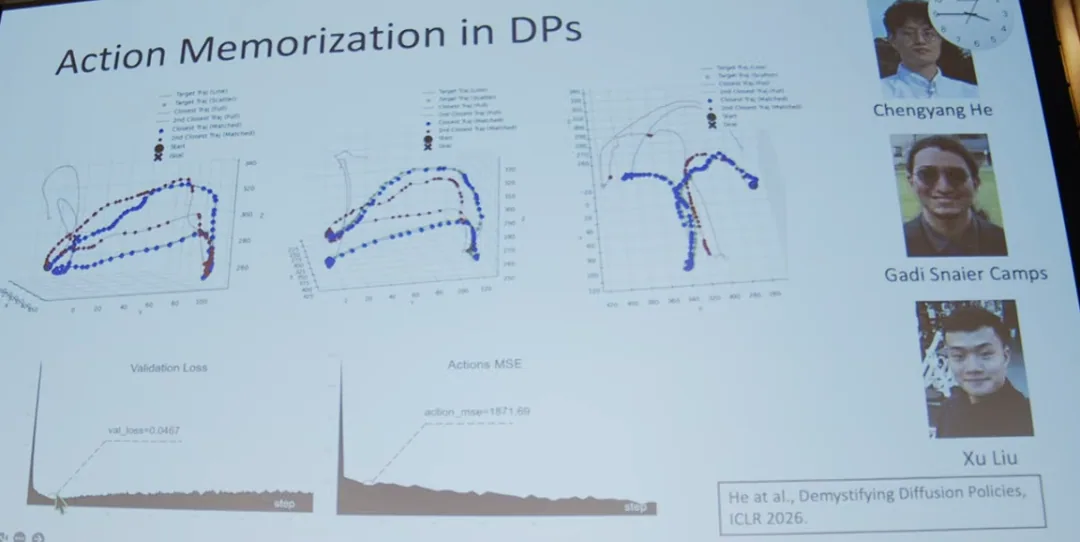
这个研究始于一个有趣的发现:我们实验室训练 Diffusion Policy 时,合作者反馈:不要在验证损失低时停止训练,否则策略效果极差;必须训练到训练损失低、验证损失高(严重过拟合)时,策略才好用。
这明显是过拟合的特征,传统机器学习理论认为过拟合会破坏泛化能力,但这却是行业标准做法。我们验证后发现确实如此:必须过拟合,策略才能工作。
进一步,我们对比模型推理输出的动作片段,与训练集中最近邻、次近邻的动作片段:推理片段(绿色)与最近邻训练片段(蓝色)几乎完全重合,次近邻(红色)则差异明显。
这说明模型本质上是在查表。我们定义了动作片段空间的相似度指标:设推理片段与训练集最近邻距离为 ,训练集次近邻与最近邻距离为 ,相似度定义为:
该指标为负表示与训练数据无相似性。
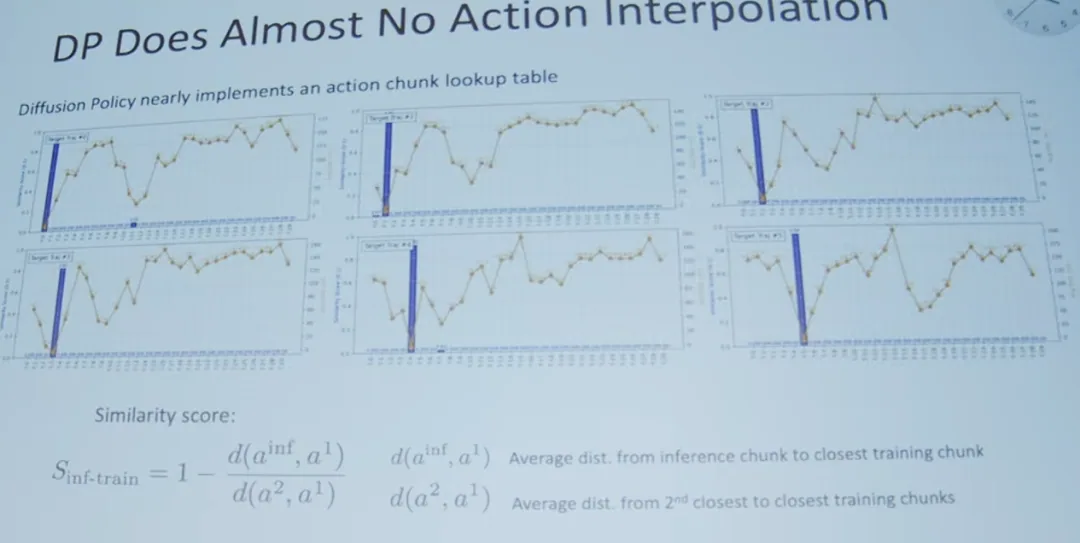
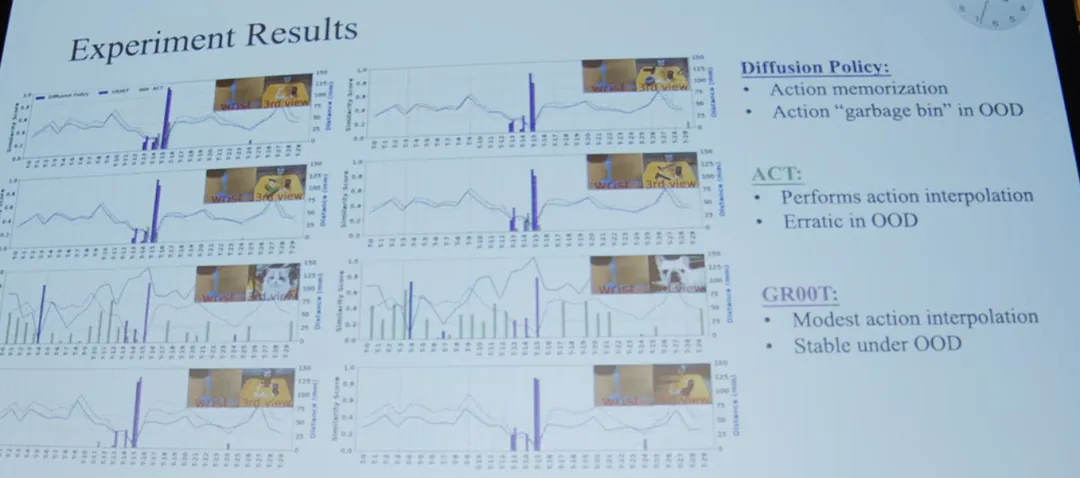
测试结果显示:所有推理的相似度都呈现独热分布,模型完全从训练集中查表输出动作。
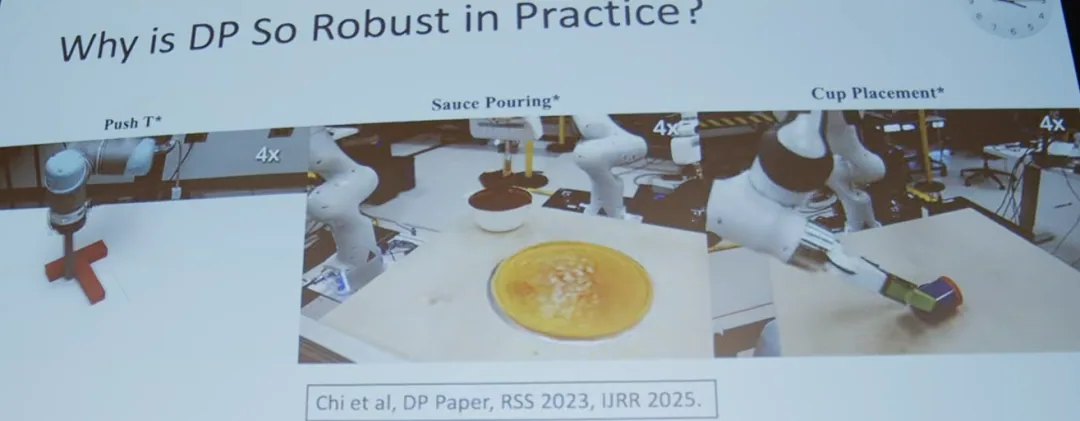
但奇怪的是,策略效果却很好。为什么记忆训练数据,还能实现稳定的闭环纠错?
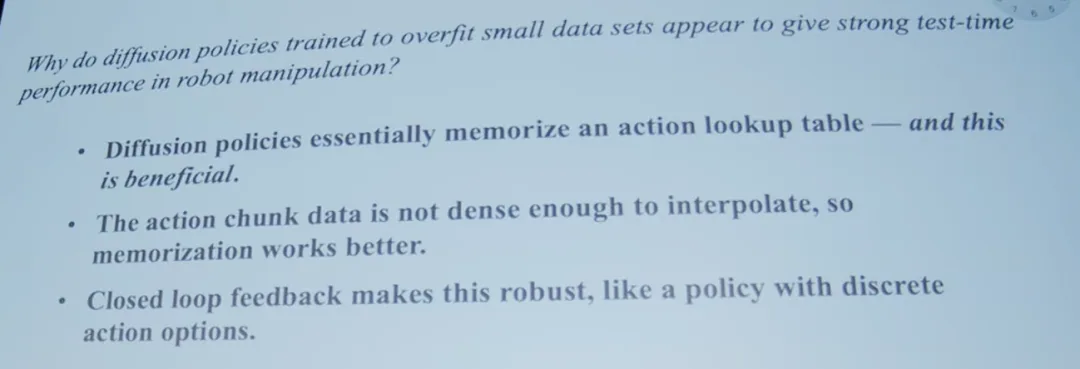
我们的假设是:Diffusion Policy 确实在记忆训练数据,但这在小数据场景下是优势。因为动作片段空间中,线性插值会生成无意义的动作(就像平均两张图像会得到噪声),只有记忆有效动作片段才能保证执行安全。而鲁棒性来自闭环反应:每帧新图像都会重新选择动作片段,通过在离散记忆片段间切换,近似实现目标行为。
Diffusion 模型的归纳偏置本身就是记忆化。我们做了一个简单验证:用稀疏采样的星形数据训练简易扩散去噪模型,推理轨迹会收敛到每个数据点的局部稳定吸引子,本质就是记忆数据点。这正是 Diffusion Policy 的小数据场景特征。
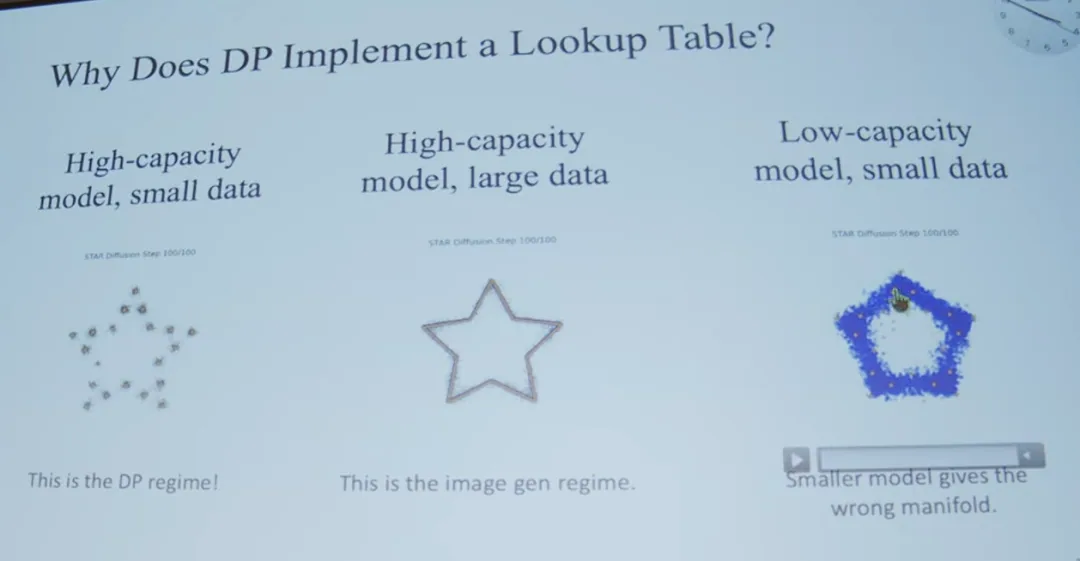
而图像生成领域,模型能泛化是因为训练数据达数十亿级,完全覆盖图像流形;但机器人动作数据远达不到这个规模。
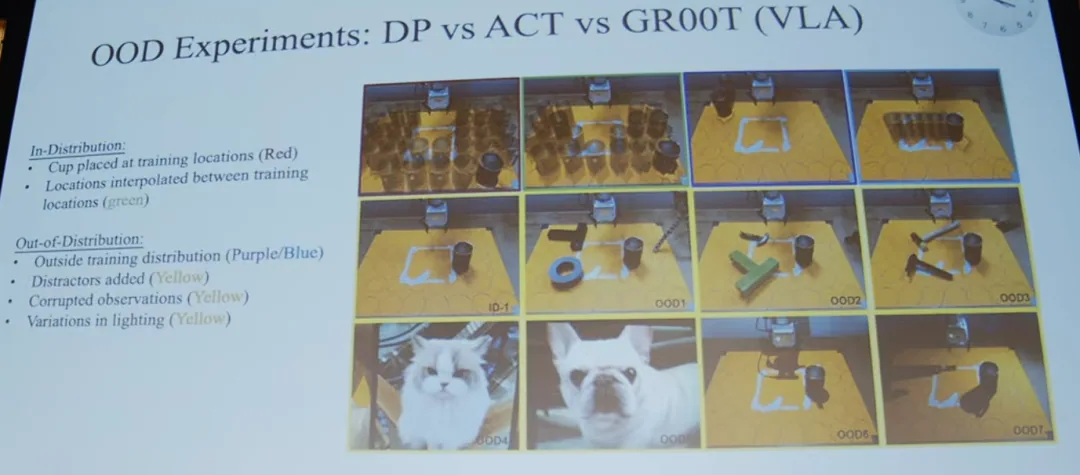
我们还对比了三类策略:
- Diffusion Policy:始终输出独热记忆动作,面对猫狗这类极端分布外图像,会固定输出同一个训练动作,行为稳定、无危险动作;
- ACT:基于 Transformer 自回归,无独热行为,但分布外输入会输出混乱、危险的动作;
- GRoot:架构与 PI 模型接近,用 PaLI-Gemma 主干 + 扩散去噪头,接近独热输出,跨分布外场景稳定,能忽略干扰、聚焦腕部相机。
我们还提出了 ALT 策略(Action Lookup Table):训练图像编码器,推理时将图像编码为隐层,做最近邻查找,直接调用对应动作序列。
- 效果:与 Diffusion Policy 相当;
- 推理速度:100Hz(Diffusion Policy 仅 2Hz);
- 存储:45MB(Diffusion Policy 约 50GB、3 亿参数)。
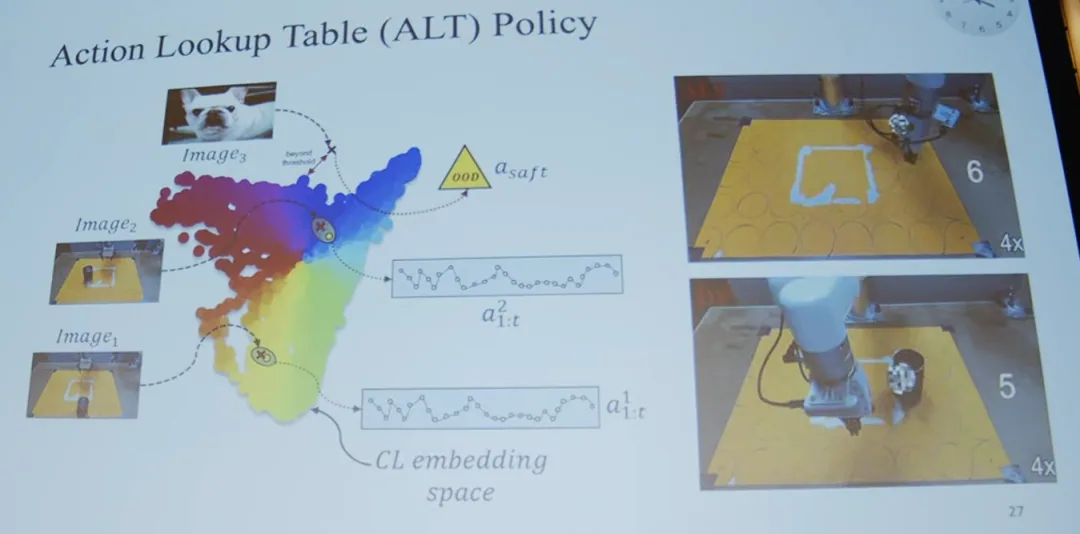
这说明:模仿学习中,用更简单、可解释的架构就能实现同等效果。
4. Doctor VLA:稀疏自编码器揭示主干 Token 记忆化
我们已经验证 Action Expert 存在大量记忆化,接下来深入 VLA 主干,分析图像与语言转为动作的 Token。
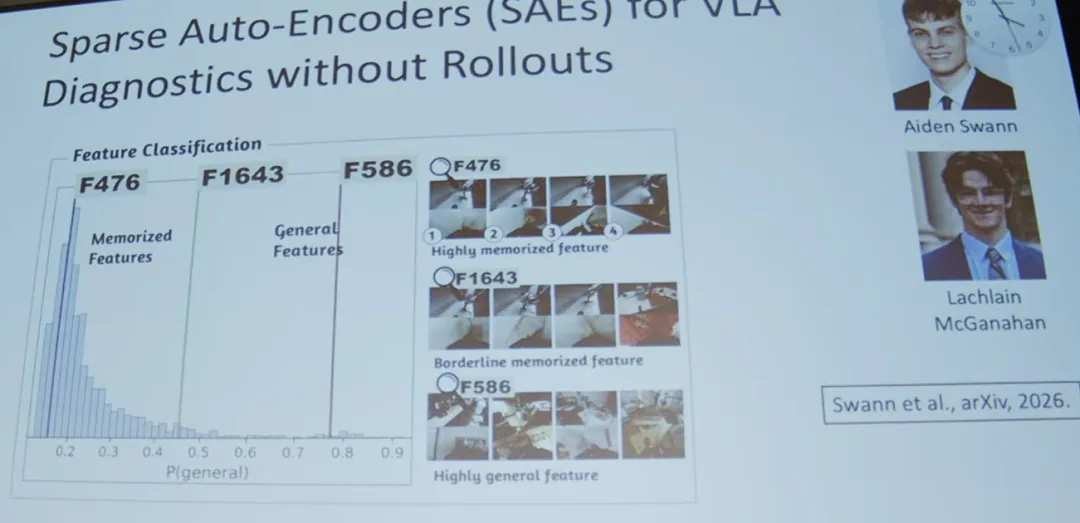
这是我学生 Aiden 和 Lachlain 的最新研究,arXiv 上名为 Doctor VLA,用于诊断 VLA 的问题。我们训练稀疏自编码器,提取 VLA 主干中 Token 嵌入的稀疏基表示,并分类为:
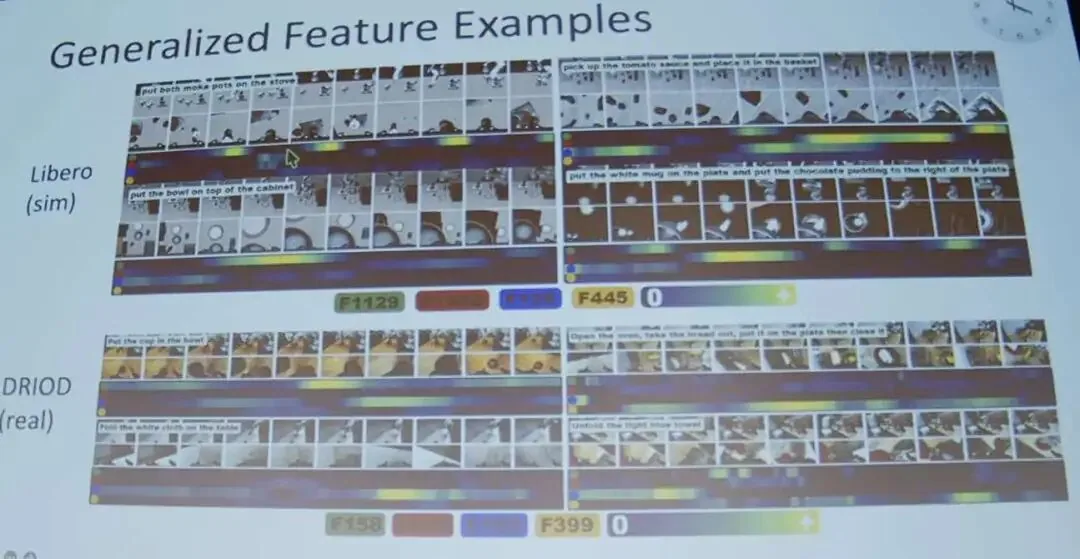
- 记忆型:仅在特定训练样本上激活;
- 通用型:在多个训练样本、不同视觉背景、不同任务中激活。
结果发现:隐层 Token 嵌入存在极高比例的记忆化。
具体来说:ViT 生成的 Token(语言 + 图像)进入残差流,经过注意力层后残差连接。我们在残差流中接入稀疏自编码器——它不是信息瓶颈,而是信息扩维器,将 Token 嵌入维度放大,用 L1 损失约束稀疏性,得到一组稀疏基,用来描述 Token。
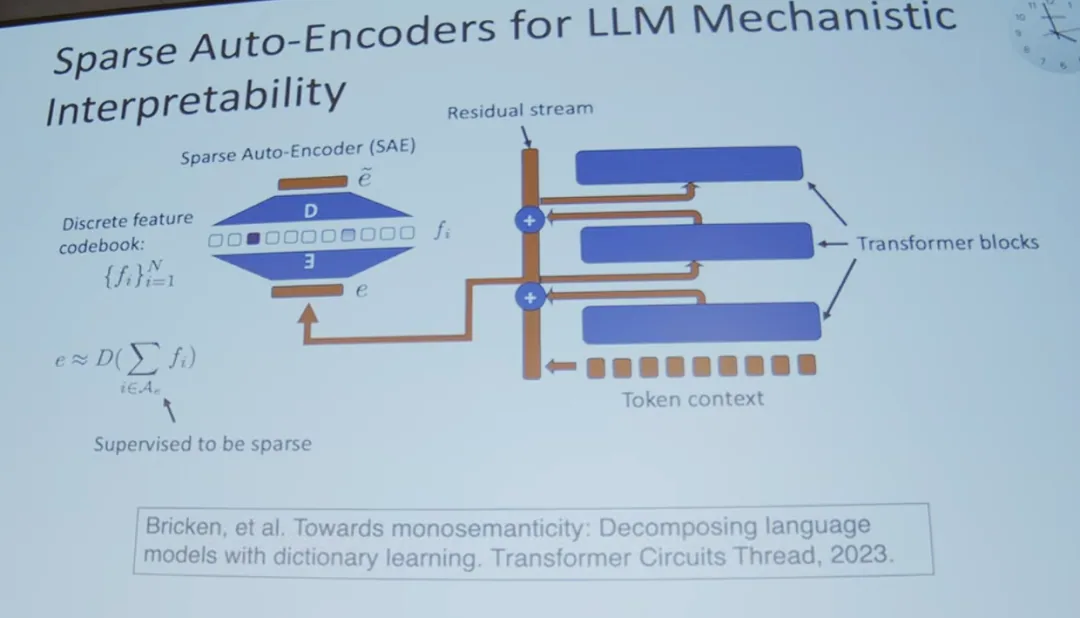
这个思路源于 LLM 的机械可解释性研究,用于分析模型学到的概念。
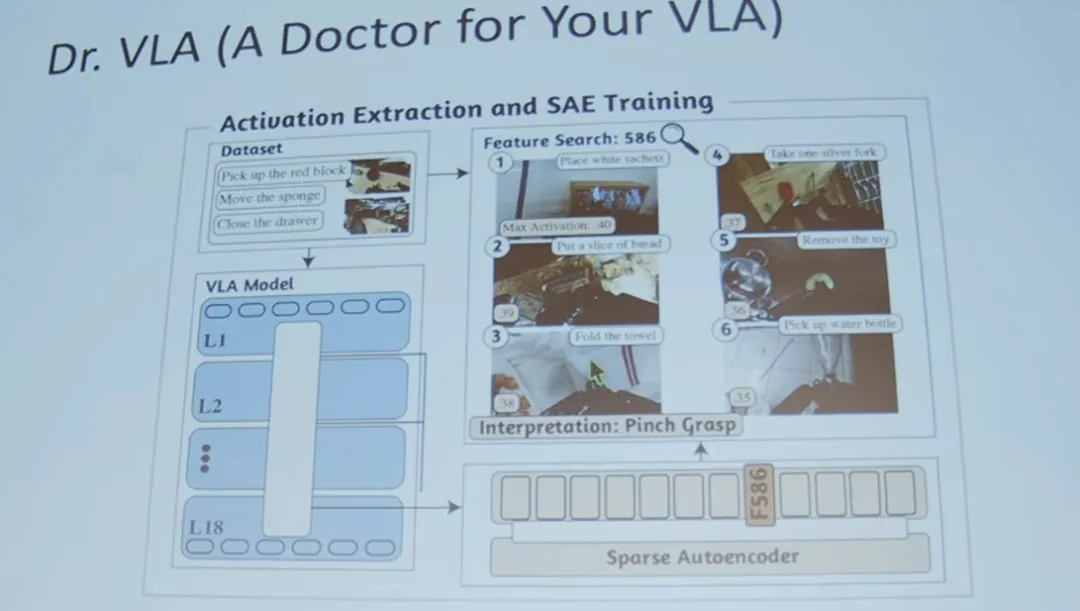
我们能直观区分通用特征与记忆特征:通用特征在多任务、多场景、多指令下激活;记忆特征仅在单个样本上激活。
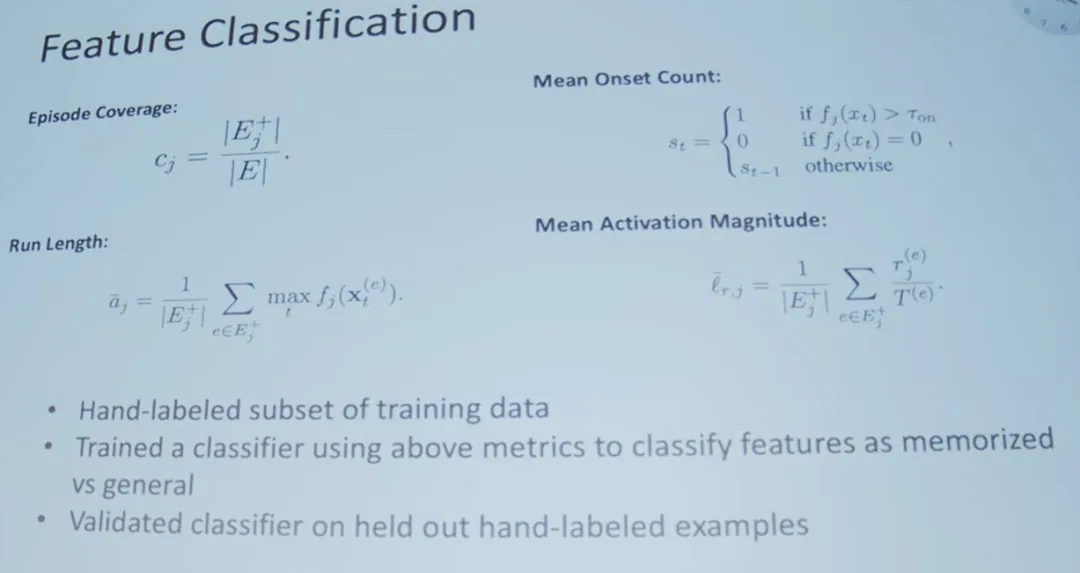
为了系统分类,我们定义了量化指标:
- 片段覆盖率:特征在多少比例的训练片段中激活;
- 平均激活次数:特征在激活片段中开关的次数;
- 激活长度:特征单次持续激活的时间;
- 激活强度:特征的平均加权系数。
用这些指标训练分类器,自动判断未标注特征是通用还是记忆型,结果如下:
- Libero 数据集(仿真、小数据):97%-98% 特征为记忆型;
- Droid 数据集(真实、大数据):89%-95% 特征为记忆型;
- OpenVLA:99.5% 特征为记忆型。
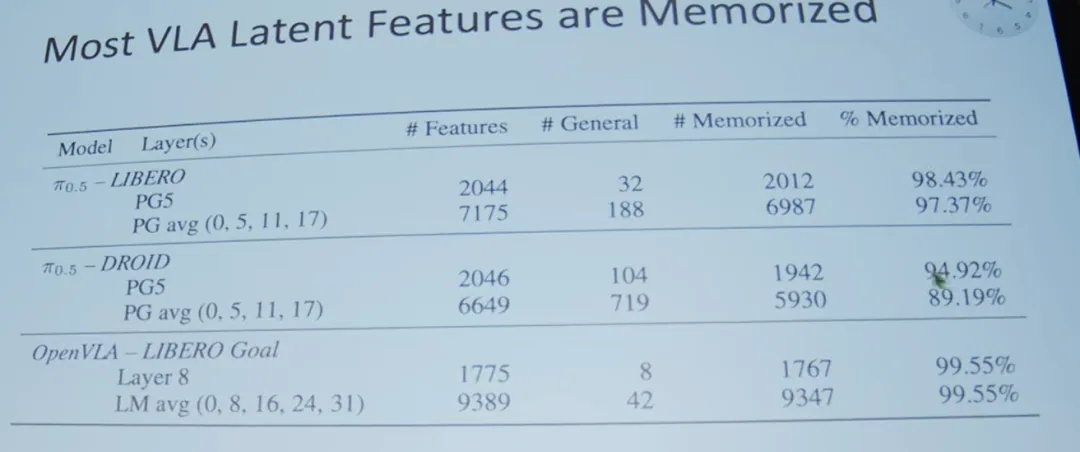
这也符合业界体验:OpenVLA 在实验室中极难使用。
但趋势明确:数据规模越大,记忆化比例越低,泛化能力越好。
5. 破局方向:数据缩放与元认知
所有研究指向的趋势:大数据 → 更好泛化。如何扩大数据规模?
- 融资建立数据工厂,雇佣人工采集;
- 用仿真、世界模型、视频生成等技术做智能数据增强;
- 提升数据多样性。
另一个核心方向:元认知。当前策略完全不具备自我感知能力,需要让模型“思考自身行为”。
我们做了两个探索:
1. 仿真数据扩充
项目名为 Pi, but make it fly,我们将 PI 模型微调用于空中操控:在四旋翼平台上加装 UMI 夹爪,用 160 条人类遥操作数据微调,发现穿越闸门任务效果极差。
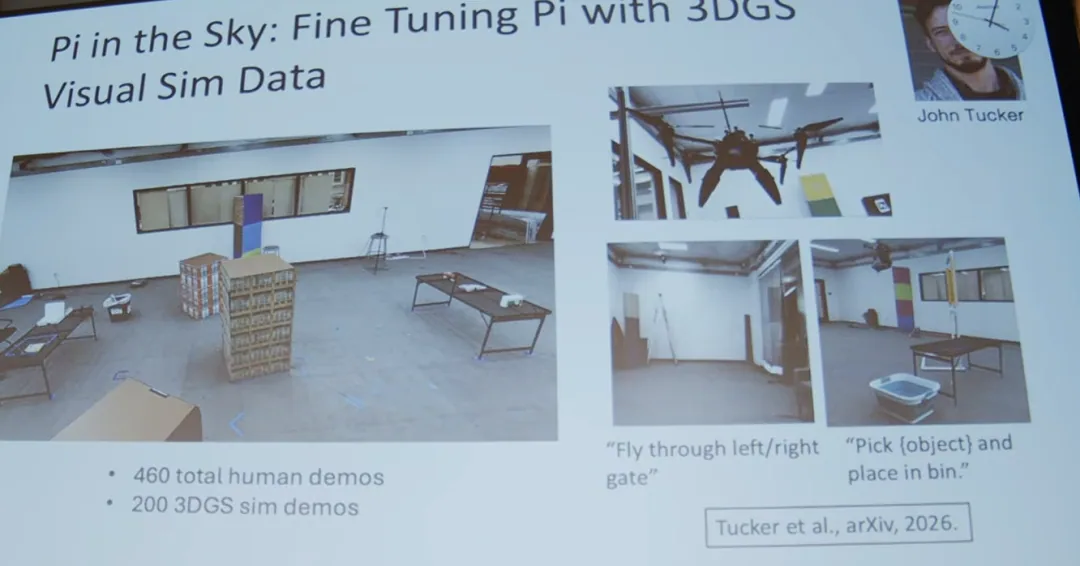
于是用 3D 高斯泼溅仿真器生成 200 条合成闸门导航数据,扩充训练集后,闸门穿越成功率从 70% 提升至 85%。
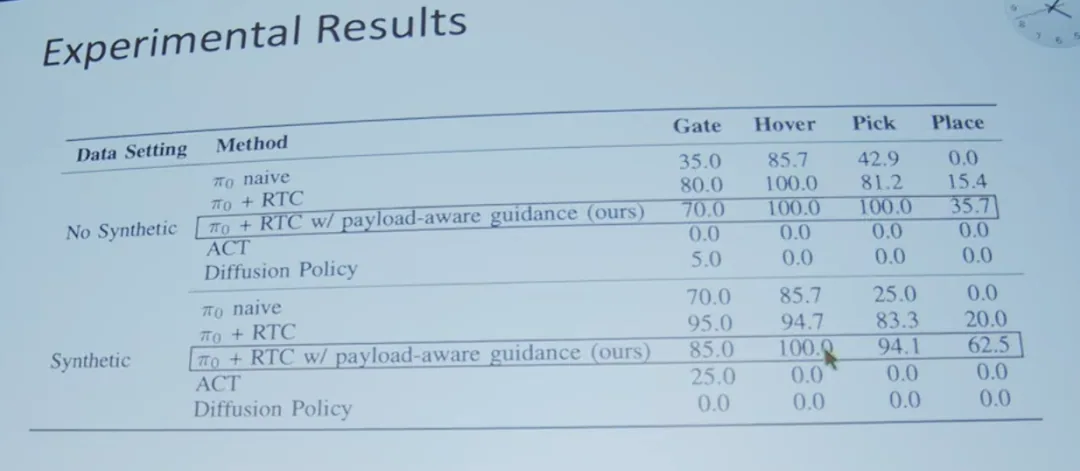
但模型仍存在严重过拟合:训练时闸门在左/右、桌子固定,一旦移动闸门或桌子,模型完全失效。不过模型具备任务组合能力:仅训练单一步骤(左闸门、右闸门、抓取放置),却能执行长序列指令(抓取零食 → 丢垃圾桶 → 穿越闸门 → 抓取三明治 → 放回桌面)。
这说明:仿真数据 + 真实遥操作数据是扩大数据规模的有效路径,未来随着世界模型、仿真器、图像生成与物理仿真的进步,能生成更真实的训练数据。
2. 任务进度模型(元认知)
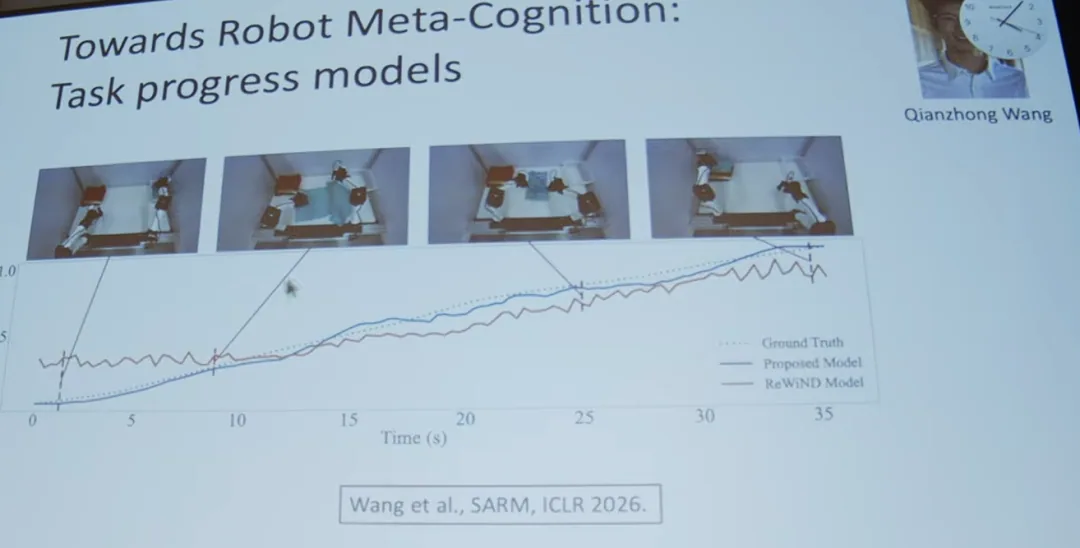
元认知的基础是感知任务执行进度。我们的学生 Qianzhong Wang 在 ICLR 即将发表的工作中,提出细粒度子任务标注与新架构,训练任务进度模型,输出 0-1 的进度值,实时判断任务完成程度。
这个信号可用于数据集筛选:只保留进度从 0 到 1 平滑过渡的高质量数据,用更小的数据集训练出成功率更高的策略(如 T 恤折叠任务)。
6. 核心总结
当前 VLA 模型的实际效果,远不如高估值企业的宣传视频。作为研究者,必须保持科学怀疑态度:若成果惊人却无法复现(无代码、数据、工具),则不应轻信,其有效性需等待复现验证。
同时,要认清工业界研究的利益冲突:企业以盈利为目的,其发表的论文需谨慎看待——并非否定谷歌、PI 等机构研究者的能力,而是研究者天然有让模型表现更优的倾向。科学的核心是可复现性,无法复现的“领先成果”不是科学,只是广告。
未来研究方向:
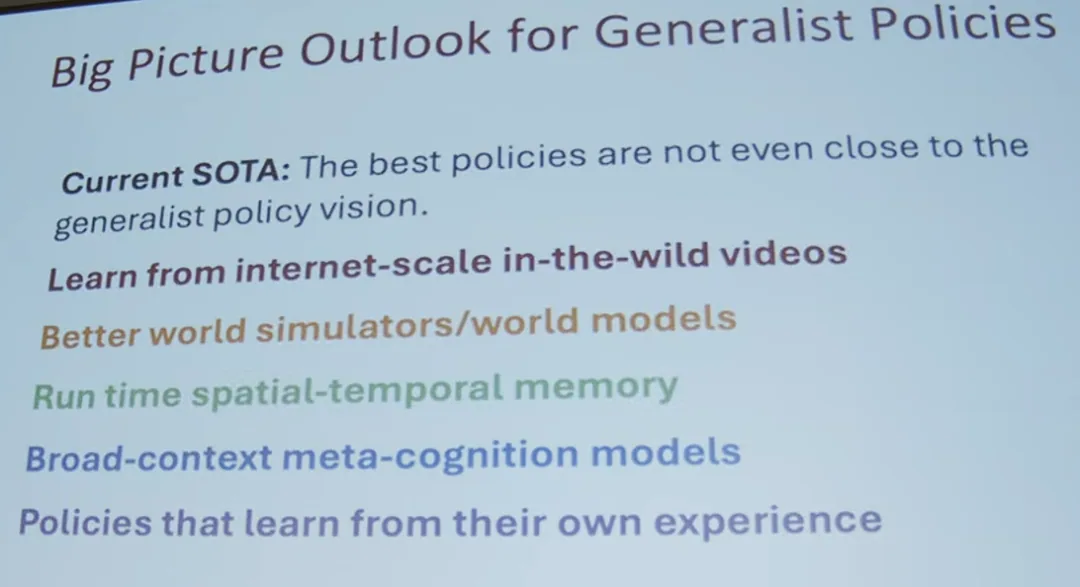
- 更大、更多样的数据集,包括合成数据、野生视频数据;
- 更好的仿真器与世界模型,低成本生成大规模数据;
- 记忆能力:当前策略是纯反馈式(无历史记忆),需引入历史信息纠错;
- 元认知:让模型感知自身执行效果,自主优化;
- 自主学习:重新定义现实世界机器人的强化学习,实现从经验中学习。
一句话总结:当前 VLA 存在大量记忆化行为,但这对研究者是好消息——问题远未解决,我们仍有大量研究可做。
7. 问答实录
问题 1:能否讲讲这些模型跨环境迁移的效果?
目前这类模型大多不是多任务通用策略,仅适配单任务或窄范围任务,跨环境迁移能力极差。
问题 2:世界模型相关研究仅用成功案例训练,无法学习失败场景,能学到真实动力学距离吗?
效果很差,相关研究还很初级。比如视频帧重排的上下文学习方法,思路巧妙但不具备可扩展性;Rewind 等方法通过逆序帧构造失败样本,也只是初步探索。所有方法都只有模仿学习数据,与策略实际 rollout 数据分布差异大,无法实现真正的自我优化。
PI 发布的 Pi-0.6 声称实现自我优化,但需要大量人工干预(人工评分、实时遥操作纠正),我们实验室尝试复现并未成功。现实世界中,机器人自主学习仍是开放问题。
问题 3:SFT 过拟合和持续学习中的灾难性遗忘高度相似,除了权重正则化,还尝试过其他方法吗?
我们尚未尝试其他方法,这是一个完全开放的研究方向,我们提出的方法也是两个月前才完成的,两者确实高度相关。
问题 4:VLA 范式降低了机器人开发门槛,从伦理角度,我们应该教机器人做什么任务?
我不想给出全行业的宽泛建议,但 OXE(Open X Embodiment) 是很有意义的尝试,只是学术界很难协同,数据集质量参差不齐。Droid 数据集因单一实验室采集、统一配置,质量更稳定。
如果学界能统一作业单元、数据格式,建立持续更新的社区数据集(动态迭代的 OXE),会极大推动研究进展。目前创业公司的核心优势,就是拥有我们研究者无法企及的海量数据。
搬运说明:本文整理搬运自微信公众号「human five」发表的《VLA 真的通用吗?—— 机器人具身策略的泛化性与记忆》(基于斯坦福大学多机器人系统实验室 Mac Schwager 副教授的专题报告整理),仅作个人学习与知识归档之用。